

基礎知識
画像解析AI向けGPUの選び方:学習・推論・分野別構成のポイント
2026.10.30

GPUエンジニア

画像解析AIは、製造業の外観検査や小売・物流の棚監視などで実用化が進んでいます。データ量と演算負荷が大きいため、GPUの性能によって扱えるモデル規模・解像度・処理速度が左右されます。
本記事では、画像解析AIで広く利用されるNVIDIA GPUを中心に、求められるGPUの性能や構成、主要なフレームワーク/ツールなどのポイントを解説します。
【目次】
- 画像解析AIの代表的なタスクと近年の潮流
- 画像解析AIワークロードに求められるGPU性能
2-1. 並列演算性能:Tensor コアと低精度演算
2-2. VRAM容量と帯域:解像度・バッチサイズ・モデル規模との関係
2-3. 学習と推論で異なる性能要件 - 画像解析AIを支える主要なフレームワーク/ツール
3-1. 学習フレームワーク/開発ツール:PyTorch・TensorFlow・NVIDIA TAO Toolkit
3-2. 推論最適化・映像解析基盤:TensorRT・DeepStream・ONNX Runtime - 分野別に見る画像解析AIの実装パターンとGPU構成
4-1. 製造業の外観検査:ライン速度に合わせた推論スループット
4-2. 小売・物流:マルチカメラでの棚監視・在庫管理 - 画像解析AIに適したGPUの選定ポイント
5-1. 学習向けの構成:スループットと大容量VRAM
5-2. 推論・エッジ向けの構成:レイテンシと電力効率
5-3. オンプレミスとクラウドの使い分け - まとめ
1. 画像解析AIの代表的なタスクと近年の潮流
画像解析AI(画像に対して「何が写っているか」をラベル付けして出力します。コンピュータビジョン/Computer Vision、CV)は、画像や動画から業務判断に使える情報を取り出すAIの総称です。近い意味で「画像認識AI」も使われますが、画像認識はコンピュータビジョンに含まれるタスクの1つ(画像分類など)を指す場合があり、単一の正式名称が業界標準として固定されているわけではありません。
本記事では実務での通用性を優先して「画像解析AI」で統一します。
画像解析AIは、主に次のような業務の自動化・効率化に実用されています。
- 良品/不良品の自動判定(製造ラインでの外観検査)
- 病変・臓器の検出とスクリーニング(CT・MRI・病理画像からの一次判定)
- 棚在庫・欠品状況の把握(小売店舗の商品棚監視、物流倉庫の在庫管理)
- 人物・車両のカウントと動線分析(施設内の人流計測、駐車場・道路の車両検出)
- 文書・帳票・看板の文字読み取り(OCR+分類による書類デジタル化)
画像解析AIの代表的なタスクは、大きく次の4つに整理できます。画像分類・物体検出・セグメンテーションが中核タスクで、画像生成は隣接する生成AI領域として位置づけられます。それぞれ、出力の形式と業務での使われ方が異なります。
① 画像分類(Image Classification)
画像に対して「何が写っているか」をラベル付けして出力します。良品/不良品判定、病変の有無の一次スクリーニング、書類の種類判別など、画像1枚単位で「YES/NO」または「カテゴリ」を返したい用途で使われます。ResNet・EfficientNetといったCNN系モデルがよく採用されます。
② 物体検出(Object Detection)
画像内の複数の被写体について「何が」「どこに」あるかを、バウンディングボックスとクラスで出力します。棚の商品検出、車両・歩行者検出、外観検査の欠陥位置特定など、1枚の画像に複数の対象が写り、それぞれの位置と種類を同時に把握したい業務で使われます。YOLOシリーズやFaster R-CNNが代表的です。
③ セグメンテーション(Segmentation)
画像を画素単位で領域分割し、各画素がどのクラスやオブジェクトに属するかを出力します。医療画像の臓器・病変の輪郭抽出、製造ラインの欠陥領域切り出し、自動運転の走行可能領域判定など、「面積」「形状」「境界線」まで正確に取り出したい業務に用いられます。U-Net・Mask R-CNN・DeepLabが中心的なモデルです。
④ 画像生成(Image Generation)
既存画像の変換や、条件を与えて新しい画像を生成するタスクです。超解像(低解像度画像を人工的に高解像度化する処理)、ノイズ除去、学習データが不足しがちな不良品パターンの合成データ生成など、手元にある画像を加工・拡張したい、あるいは学習データを人工的に増やしたい業務で活用が広がっており、GAN(Generative Adversarial Network:生成側と識別側のネットワークを競わせて学習する仕組み)や拡散モデル(Diffusion Model:ノイズを徐々に取り除きながら画像を生成する仕組み)が主要な手法です。
これら4タスクは長らくCNNベースの手法が中心でしたが、近年はVision Transformer(ViT:画像をパッチに分割してTransformerアーキテクチャで扱うモデル)、Segment Anything Model(SAM:Meta AIが公開した汎用セグメンテーションモデル)、画像とテキストを同時に扱うCLIP・BLIPなどのマルチモーダルモデル(画像と言語の両方を1つのモデルで扱う仕組み)、Stable Diffusion等の生成AIを用いた拡散モデルなど、新しい潮流が加わっています。
2. 画像解析AIワークロードに求められるGPU性能
画像解析AIの学習・推論では、大量の畳み込み演算や行列積、Attention演算が繰り返されます。大規模な学習や高いスループットが求められる推論ではGPUを利用する構成が主流です。(軽量な推論はCPUやエッジアクセラレータでも動作します)。
学習と推論、モデル規模、扱う画像解像度などによっても、求められるGPU性能特性は変わるため、以下ではGPU選定時に押さえるべき3つの性能特性を整理します。
2-1. 並列演算性能:Tensor コアと低精度演算
画像解析AIの学習・推論では、畳み込み層やAttention層で大量の行列積が実行されます。この処理を効率化するのが、幅広いNVIDIA GPUに搭載されているTensor コア(テンソルコア)です。小行列の積和演算を並列処理する専用ユニットで、対応する精度・演算では汎用CUDA®コアより高い理論スループットを提供します。
Tensor コアの活用で重要になるのが演算精度の選び方です。学習では勾配計算の安定性を優先してFP16(半精度浮動小数点)やBF16(bfloat16:仮数部を狭めて指数部を広げた16bit浮動小数点。FP32と同等の数値範囲を扱え、深層学習の学習向けに設計された形式)が中心ですが、推論では精度をFP8・INT8、Blackwell世代以降ではFP4まで精度を下げることで、スループットと電力効率を大きく引き上げています。
以下の表は、代表的な演算精度の位置づけを整理したものです。
| 演算精度 | ビット幅 | 主な用途 | メリット |
|---|---|---|---|
| FP32 | 32bit | 一部の学習用途など、数値精度が必要な処理 | 高精度、既存資産との互換性 |
| FP16/BF16 | 16bit | 学習 | FP32比でテンソル1要素の容量が半分になる |
| FP8 | 8bit | 学習・推論 | 学習用途でも活用可能な低精度 |
| INT8 | 8bit(整数) | 推論 | 高いスループット、量子化ツールが成熟 |
| FP4 | 4bit | 推論 | 高い理論スループット |
(自社調べ)
扱うタスクがどの精度で成立するかを踏まえて、GPUの世代・型番やTensor コアの対応精度を照らし合わせることが重要になります。
2-2. VRAM容量と帯域:解像度・バッチサイズ・モデル規模との関係
画像解析AIでは、VRAM(Video RAM:GPU専用メモリ)の容量と帯域が、学習・推論の実行可否とスループットを大きく左右します。VRAM消費量は、モデルのパラメータ数、入力画像の解像度、バッチサイズ、活性化テンソルに加えて、学習時は勾配・オプティマイザ状態・一時バッファなども合わせて見積もる必要があります。
高解像度画像(4K・医療用の高精細画像)、動画フレーム、3Dボリューム(CT・MRI)を扱う場合は画像1枚あたりのメモリ消費が大きくなるため、バッチサイズを下げるかより大容量VRAMのGPUを選ぶ必要があります。VRAMの帯域(メモリとGPUコア間のデータ転送速度)も学習速度に直接影響し、データセンター向けGPUに採用されるHBM(High Bandwidth Memory)はGDDRメモリと比較して高いメモリ帯域を備えています。
以下の記事では、データセンターGPUの世代ごとの理論性能・VRAM容量・帯域を比較しています。
▶︎ データセンターGPU性能比較:指標別に見る製品の選定ポイント
2-3. 学習と推論で異なる性能要件
画像解析AIのGPU構成を検討するうえで、学習と推論では要件が大きく異なります。同じモデル・同じタスクでも、フェーズによって重視する指標が変わります。
- 学習フェーズ:モデル全体のパラメータを繰り返し更新するため、大容量VRAM、高い演算スループット、マルチGPU間の高速通信(NVIDIA NVLink™:GPU同士を直結する高帯域インターコネクト)が重要です。バッチサイズを大きく取れるほどGPUの利用率を高めやすくなるため、VRAM容量が学習効率を左右します。
- 推論フェーズ:本番環境で稼働させる段階では、レイテンシとスループット、消費電力あたりの処理性能が重視されます。オンライン低遅延用途ではバッチサイズを小さく、量子化(モデルの数値精度を下げて計算量とメモリ消費を削減する手法、FP8・INT8など)や推論最適化ライブラリで応答時間を抑えるのが典型的です(オフラインバッチ推論ではバッチを大きく取る場合もあります)。
開発・検証を行う環境と、本番推論を行うためのGPUを分けるというハイブリッド構成も選択肢の一つです。
3. 画像解析AIを支える主要なフレームワーク/ツール
画像解析AIの実装は、学習フレームワークと推論最適化ライブラリ、モデル実装のライブラリ群を組み合わせて行われます。GPUを最大限に活かすには、これらのソフトウェアスタックが利用するGPUアーキテクチャに最適化されている必要があります。
ここでは、主要なフレームワーク/ツールを、学習・開発と推論・運用の2つに分けて整理します。
3-1. 学習フレームワーク/開発ツール:PyTorch・TensorFlow・NVIDIA TAO Toolkit
深層学習モデルの学習で広く使われているのが、PyTorch と TensorFlow の2つのフレームワークです。どちらもCUDA・cuDNN経由でNVIDIA GPUを利用でき、Tensor コアを活用した混合精度学習に対応しています。
また、NVIDIAが提供する画像解析AI向けの開発ツールキットであるNVIDIA TAO Toolkitも多くのユーザーに活用されています。
PyTorch
研究と産業実装の両方で採用が広がっており、動的計算グラフによる柔軟なモデル記述が特徴です。Ultralytics YOLOやHugging Face Transformersなど、主要ライブラリの多くがPyTorchベースで実装されています。
TensorFlow
Google発の歴史あるフレームワークで、KerasによるHigh-Level APIとLiteRT(旧TensorFlow Lite)によるモバイル展開まで含む幅広いエコシステムを持ちます。
NVIDIA TAO Toolkit
TAO:Train, Adapt, Optimizeの略で、事前学習済みモデルを自社データに合わせて再学習・最適化するための一気通貫の環境です。事前学習済みモデルのファインチューニングに加え、TAO 7では画像解析向けの基盤モデル(Vision Foundation Model)やVLM(Vision Language Model:画像と自然言語を同時に扱うマルチモーダルモデル)のカスタマイズ、agent skills(データ変換・学習・評価・AutoML・推論などのワークフローをコーディングエージェントから実行するスキル群)を介したポストトレーニングまで対応しています。
学習済みモデルはONNXへエクスポートし、対象環境向けのNVIDIA TensorRTエンジンを生成してNVIDIA DeepStream SDKのパイプラインに組み込む流れで展開できるため、独自データセットで開発を短期間で立ち上げたい場合の有効な選択肢になります。
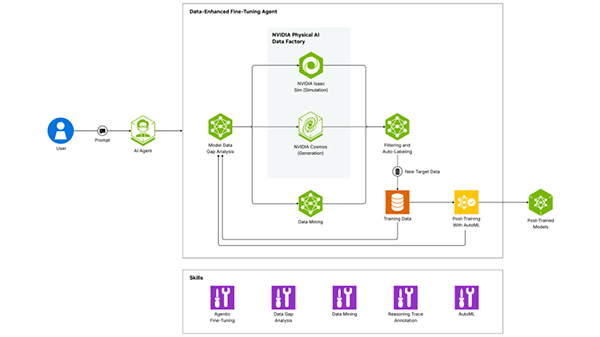
NVIDIA TAO Toolkitのagent skillsによるData-Enhanced Fine-Tuningフロー。
NVIDIA Isaac Sim™・ NVIDIA Cosmos™による合成データ生成と
AutoMLでのポストトレーニングを一気通貫で扱う
(引用:NVIDIA)
3-2. 推論最適化・映像解析基盤:TensorRT・DeepStream・ONNX Runtime
学習済みモデルを本番環境で運用する際は、PyTorch・TensorFlowなどの学習フレームワークをそのまま使う場合と、推論最適化ライブラリで最適化する場合があります。画像解析AIで利用される主要な3つのライブラリを解説します。
NVIDIA TensorRT
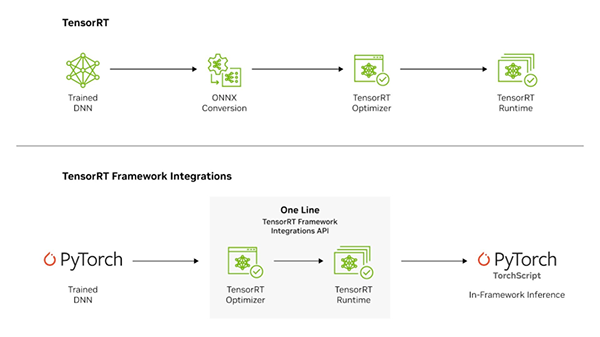
NVIDIA GPU向けの推論最適化エンジンです。カーネル融合(複数の演算を1つのGPU処理にまとめる最適化)、混合精度演算(FP16/BF16)、量子化(FP8/INT8/FP4への数値精度削減)、動的シェイプ(入力サイズが実行時に変わる場合にも1つの最適化済みモデルで対応する仕組み)などを利用し、モデルやGPU構成に応じてレイテンシやスループットを最適化します。
NVIDIA DeepStream SDK
複数のカメラの映像ストリームをリアルタイムに解析するために設計されたパイプラインSDKです。デコード(NVDEC:NVIDIA GPU内蔵の動画デコード専用ユニット)→前処理→AI推論(TensorRT、またはDynamo(NVIDIA Dynamo:分散推論を扱う推論サービングフレームワーク)連携によるPyTorch/TensorFlow)→トラッキング(フレーム間で同一物体を追跡する処理)→出力までをゼロコピー(処理段階間でバッファを共有し、CPU・GPU間などの不要なデータコピーを抑える仕組み)を活用したハードウェアアクセラレーションで実行し、監視・小売・製造ラインなど動画解析を軸にした実装で採用されます。
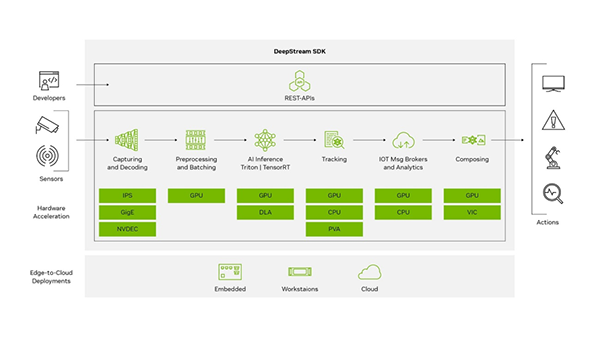
DeepStream SDKのパイプラインと各ステージへの
ハードウェアアクセラレータ(NVDEC・GPU・DLA・VIC・PVA)割当。
DLA=Deep Learning Accelerator、VIC=Video Image Compositor、PVA=Programmable Vision Accelerator
(引用:NVIDIA)
ONNX Runtime
Microsoft中心に開発される、フレームワーク横断の推論ランタイムです。ONNX(Open Neural Network Exchange:異なる深層学習フレームワーク間で共通に扱えるモデル表現形式)にエクスポートしたモデルをCPU・GPU・専用アクセラレータで実行でき、マルチプラットフォーム展開を前提とする場合に採用されます。
TensorRTの全体像や最適化の手法については、以下の記事でも解説しています。
▶︎「TensorRTとは?“AIが遅い”を解決する、NVIDIAの頭脳チューナー」— AIがもっと速く、軽く、手の届く存在になるために —
4. 分野別に見る画像解析AIの実装パターンとGPU構成
幅広い分野で実装の進む画像解析AIですが、扱うデータの特性と業務要件によって、実装パターンやGPU構成の考え方が変わります。ここでは、代表的な2分野について、ユースケースと実装上の特徴、適したGPU構成(構築者・R&D観点)を紹介します。
なお、以下で挙げるGPUはあくまで代表例です。大規模モデルや高解像度データの学習ではデータセンターGPU(NVIDIA HGX™ H200など)、中小規模モデルの学習ではNVIDIA RTX PRO™シリーズも候補になります。推論用途では、モデル規模と設置場所に応じてNVIDIA Jetson™シリーズやNVIDIA DGX Spark™なども検討することができます。
4-1. 製造業の外観検査:ライン速度に合わせた推論スループット
ユースケース
これまで熟練検査員の目視に依存していた傷・汚れ・欠け・組み付け不良の判定を自動化し、検査工程の省人化や人員配置の最適化を図りながら、判定基準の属人化と見逃し・過剰検出のバラつきを抑えられます。24時間稼働の高速ラインで人手を張り付けずに品質を担保したい、といった要件と相性の良い領域です。
実装上の特徴
- 推論スループット重視: 生産ラインのタクトタイム(1個あたりの製造時間)に間に合う速度で判定する必要があり、レイテンシの短さと1秒あたりの処理枚数が重要になります。物体検出・セグメンテーション・分類を組み合わせた複数タスク構成も採用されます
- エッジ配置: 生産ライン近傍にGPUを配置し、通信遅延なくリアルタイムに判定するエッジ推論(クラウドを介さず現場側の機器で推論を完結させる方式)が採用されるケースがあります
GPU構成
低レイテンシが求められる製造現場で活用する場合は、推論向けGPUがファーストチョイスとなる場合が多いでしょう。ライン内の省スペース設置で軽量な物体検出・分類モデルを扱うならJetsonシリーズ(エッジAI向けの小型モジュール型GPUプラットフォーム)、より大規模・複数のモデルを処理する場合や、実行環境を工場内のサーバーラックに集約するならRTX PROシリーズを搭載したエッジサーバーなどが候補になります。
また、学習は別環境(データセンター)で事前に行い、学習済みモデルをTensorRTで量子化・最適化してDeepStreamの推論パイプラインに組み込み、エッジGPUへ展開する運用なども選択肢になります。
4-2. 小売・物流:マルチカメラでの棚監視・在庫管理
ユースケース
欠品検知や陳列乱れの検出、来店客の滞在動線や購買行動の可視化、倉庫内でのピッキング作業のミス検知・作業時間分析など、これまで人手で棚札を確認したり監督者が現場を巡回して把握していた情報を、常時カメラ経由で取得できるようにします。収集した情報は、欠品対応や店舗レイアウトの改善、作業工程の見直しなどに活用できます。
実装上の特徴
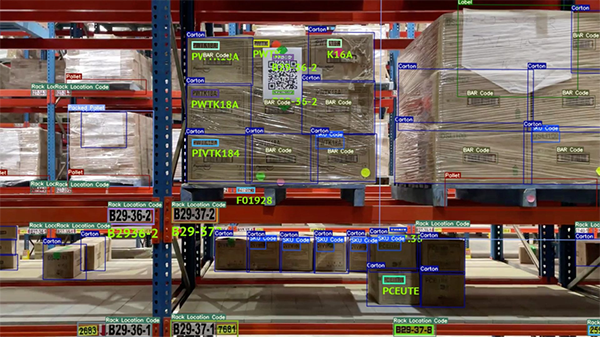
- マルチカメラ・広域監視: 店舗内・倉庫内に複数のカメラを設置し、それぞれの映像ストリームを同時に解析する構成が代表的です
- 物体検出・トラッキング+動画解析パイプライン: 商品・人・カートなど複数の対象を検出し、フレーム間で同一物体を追跡します。デコードから検出・トラッキング・集計までを、ゼロコピーと複数のハードウェアアクセラレータを活用して処理するDeepStreamベースのパイプラインが採用されることもあります
GPU構成
複数の動画ストリームを同時に処理するためのスループットが判断軸になります。1台のNVIDIA Blackwell アーキテクチャ搭載サーバーに複数のストリームを集約する構成、あるいは店舗ごとにJetson系のエッジデバイスを配置する構成が候補となり、処理可能なストリーム数はモデル・解像度・フレームレートで変わります。
5. 画像解析AIに適したGPUの選定ポイント
これまで整理した性能特性・フレームワーク/ツール・分野別実装パターンを踏まえて、実際にGPUを選ぶときに押さえるべき判断軸を整理します。学習用途か推論用途か、そしてオンプレミスとクラウドの使い分けといった点が主要な判断ポイントになります。
5-1. 学習向けの構成:スループットと大容量VRAM
画像解析AIの学習用途では、モデル規模と学習データ量に対応できる演算スループットと大容量VRAMを持つGPUが必要です。データセンター向けGPUが主な候補で、FP16/BF16/FP8で高いTensor コア性能を提供します。分散学習では、ノード内は複数のGPUをNVIDIA NVLinkとNVIDIA NVSwitch(複数のNVLinkを束ねてGPU間通信を全対全で成立させるスイッチIC)で直結し、ノード間はInfiniBand(データセンター向けの低遅延・高帯域な通信規格)やロスレスEthernetでスケールアウトするのが基本構成です。
NVIDIA HGX(NVIDIAが提供するマルチGPUベースボード規格)ベースのNVIDIA認定システムや、NVIDIA DGX™システム(NVIDIA純正の完成品GPUサーバー)は、拡張性に優れているため、大規模学習のためにマルチノード構成を取る際の有力な選択肢となります。
5-2. 推論・エッジ向けの構成:レイテンシと電力効率
推論用途では、レイテンシと消費電力あたりの処理性能が主な判断軸になります。データセンター内での集約推論では、NVIDIA RTX PRO™ 6000 Blackwell Server Edition(FP4対応・96GB)などが候補で、低精度演算による高いスループットと電力効率を両立します。
エッジ配置では、消費電力・サイズ・耐環境性の観点でNVIDIA Jetson AGX Orin™や NVIDIA Jetson Orin Nano™といったモジュールも選択肢になります。TensorRTで量子化・最適化し、対象環境ごとに推論エンジンを生成・展開する運用は、データセンター推論とエッジ推論に共通します。
5-3. オンプレミスとクラウドの使い分け
画像解析AIのGPU基盤をオンプレミスで持つか、クラウドで借りるかは、データ機密性・稼働率・TCOの3つの観点で判断します。
- オンプレミスが有力なケース: 医療・製造業・公共など機密性の高いデータを扱う場合、あるいは常時稼働でGPU使用率が高い運用では、TCO・データガバナンスの両面で有利になる可能性があります。
- クラウドが有力なケース: 検証・PoC段階や一時的な大規模学習のバースト用途では初期投資を抑えられます。検証期間中だけクラウドを活用し、本番運用は別基盤に切り出すハイブリッド構成も選択肢になります。
オンプレミスとクラウドの比較、およびデータサイエンス全般のGPU導入判断については、以下の記事で整理しています。
▶︎ GPUサーバー導入における、オンプレミスとクラウドの比較
▶︎ データサイエンスを加速するGPU:機械学習・大規模データ分析における活用法と業務要件から考えるGPU導入判断のポイント
6. まとめ
本記事では、画像解析AI向けGPUの選定に必要な性能特性と、学習・推論の構成、主要なフレームワーク/ツール、各ユースケースにおける実装パターンなどを整理しました。
NTTPCは、NVIDIAエリートパートナーとして、画像解析AIを支えるGPUの選定から学習・推論の構成設計、オンプレミスとクラウドの使い分けなど、お客さまの業務要件に合わせて設計・提案します。GPUの導入をお考えの方はぜひご相談ください。
▶︎ お問い合わせはこちら
※NVIDIA、NVIDIAロゴ、Blackwell、CUDA、DeepStream、DGX、Isaac Sim、Jetson、NVIDIA Cosmos、NVIDIA HGX、NVIDIA RTX、NVIDIA DGX Spark、NVLink、NVSwitch、TAO Toolkit、Tensor コア、TensorRT、NVIDIA Jetson AGX Orin 、NVIDIA Jetson Orin Nanoは、米国およびその他の国におけるNVIDIA Corporationの商標または登録商標です。
※PyTorchおよびONNXは、The Linux Foundationの商標または登録商標です。
※TensorFlow、TensorFlowロゴおよび関連するマークは、Google LLCの商標です。
※Google、Keras、LiteRTは、Google LLCの商標または登録商標です。
※MicrosoftおよびONNX Runtimeは、Microsoftグループ企業の商標です。
※MetaおよびSegment Anythingは、Meta Platforms, Inc.の商標または登録商標です。
※UltralyticsおよびUltralytics YOLOは、Ultralytics, Inc.の商標または登録商標です。
※Hugging FaceおよびTransformersは、Hugging Face, Inc.の商標または登録商標です。
※Stable Diffusionは、Stability AI Ltd.の商標または登録商標です。
その他、記載されている会社名、製品名、サービス名などは、各社の商標または登録商標です。