

技術解説
【後編】現実世界を学ぶAIへ NVIDIA Cosmos 3で変わるフィジカルAI開発
2026.09.30

サービスクリエーション本部
GPUエンジニア
岡本 朋之

【目次】
前編では、フィジカルAIの基本的な考え方、現実世界のデータだけでは学習・検証が難しい理由、そしてNVIDIA Cosmos 2.xからCosmos 3への進化の概要を解説しました。後編では、Cosmos 3で強化された物理推論、世界生成、条件付き生成Controlled Generation)、行動生成の各機能を整理し、フィジカルAI開発における活用のポイントを見ていきます。
1. Physical Reasoning:物理世界の関係を推論する
フィジカルAIが安全に行動するためには、カメラに映った物体の名前を認識するだけでは不十分です。物体がどこにあり、どの方向へ動き、周囲の物体とどのように関係し、次に何が起こる可能性があるのかまで推定する必要があります。
Cosmos 2.xまでのCosmos Reasonは、動画や画像から空間関係、時間変化、物体状態、動作、物理常識に関するパターンを読み取り、「何が起きているか」「どのような要因が関係している可能性があるか」「次にどのような対応が考えられるか」を推論するモデルとして提供されていました。
例えば自動運転では、前方車両の減速と歩行者の横断開始を関連する事象として捉え、自車の減速や停止を検討すべき状況である可能性を推論する、といった用途が考えられます。ただし、モデルの推論結果だけで車両制御の安全性が保証されるわけではありません。
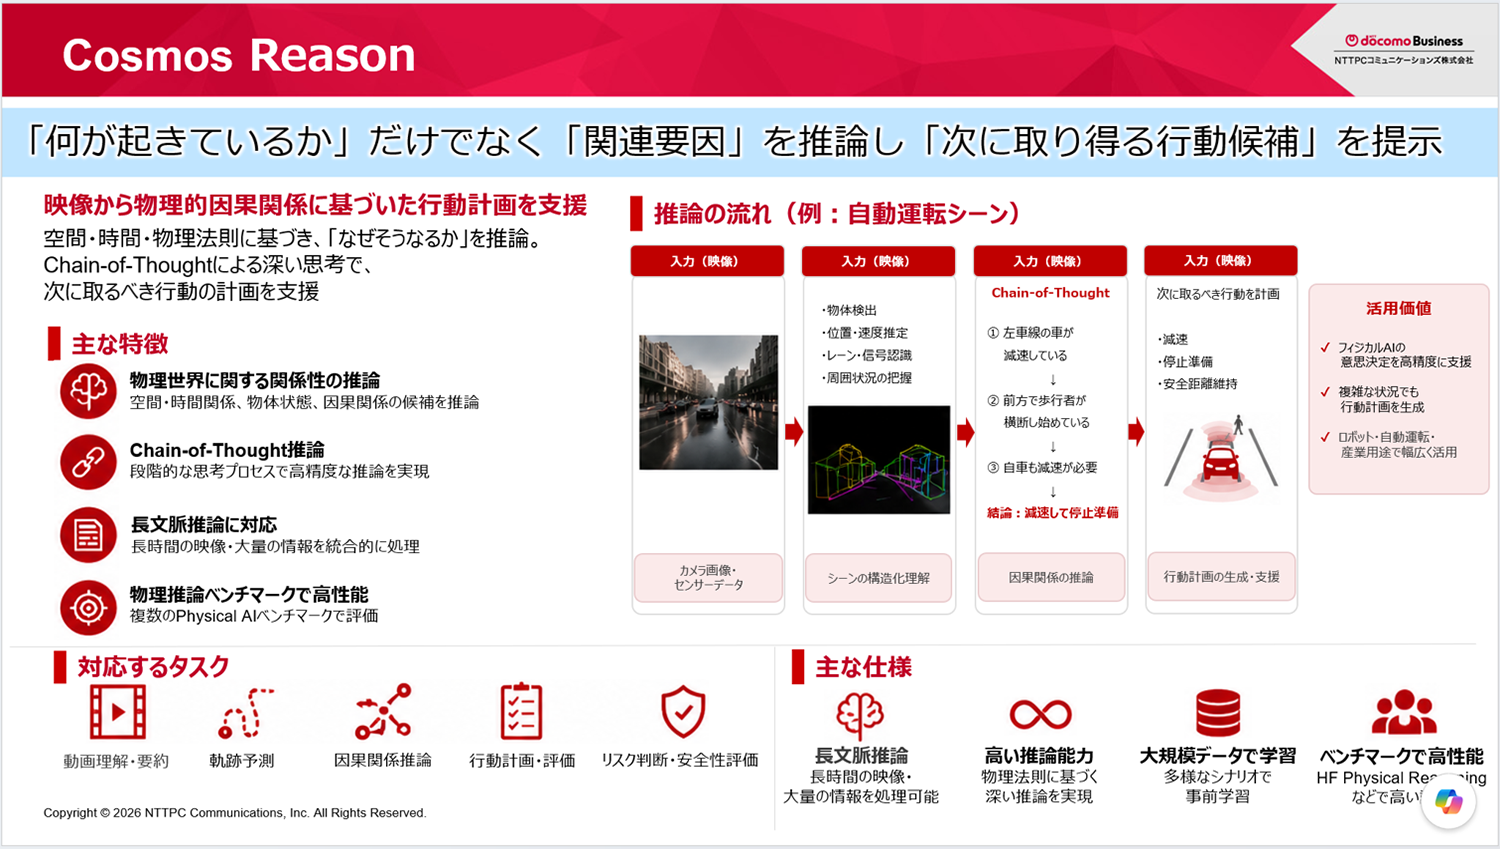
図2 Cosmos Reasonにおける物理的・時空間的関係の推論例。
Cosmos 3ではReasoner Towerが対応する機能を担う
Cosmos 3では、この物理推論を「Reasoner Tower」が担います。Reasoner Towerは、画像、動画、テキストなどの観測情報から、物体の動き、相互作用、空間・時間関係、タスク上の文脈を推論します。これは学習データに基づく推論であり、物理法則や因果関係を明示的に演算する物理シミュレータではありません。単独の視覚言語モデルとしても利用できますが、推論結果をGenerator Towerへ渡し、未来の世界や行動系列の生成条件として利用できることが大きな特徴です。
これにより、従来のReasonが担っていた「状況理解や行動計画の推論」を、Cosmos 3ではGeneratorによる未来世界や行動系列の生成へ直接接続できるようになりました。
▶︎ フィジカルAIの推論基盤「Cosmos Reason」をローカル環境で検証― Isaac SIM連携によるロボット環境理解AIの実装 ―
2. World Generation:物理的文脈を考慮した未来候補を生成する
フィジカルAIの開発では、現在の状況を理解するだけでなく、「このまま進むと何が起きるか」を予測する必要があります。自動運転であれば前方車両や歩行者の数秒後を予測し、ロボットであればアームを動かした結果として対象物や周囲がどう変化するかを予測します。
Cosmos 2.xまでのCosmos Predictは、テキスト、画像、動画を入力条件として、学習データから獲得した時空間的・物理的パターンに基づく未来の動画シーケンスを生成するモデルでした。一般的な動画生成に加え、フィジカルAIで用いる世界状態の生成を志向している点が特徴です。
ただし、明示的な物理シミュレータではなく、生成結果が物理法則を常に満たすことを保証するものではありません。また、長時間生成やマルチビュー生成などの機能も拡張されました。
Generator Towerは、Reasoner Towerが入力から推論した物体の動き、相互作用、空間・時間関係などを条件として、将来の画像や動画の候補を生成します。
重要なのは、見栄えのよい動画の生成だけを目的とせず、フィジカルAIの学習・評価に利用することを想定した、物体関係、動き、時間変化などの文脈を持つデータ候補を生成することです。これにより、フィジカルAI学習に利用可能な動画を大量に生成し、学習データの作成コストや時間を削減できるというメリットがあります。ただし実際に学習・評価に使用する前には、現実データとの比較や品質検証が必要です。
さらにCosmos 3は、Actionデータを用いたpost-trainingによって、Actionを条件として将来観測を予測するForward Dynamicsにも適応できます。現在の観測とAction軌跡から、そのAction後に得られる可能性のある将来観測を生成することで、「特定のActionを取った場合に世界がどのように変化し得るか」を検討できます。ただし、生成結果は物理シミュレータによるGround Truthではなく、学習データに基づく近似的な予測です。
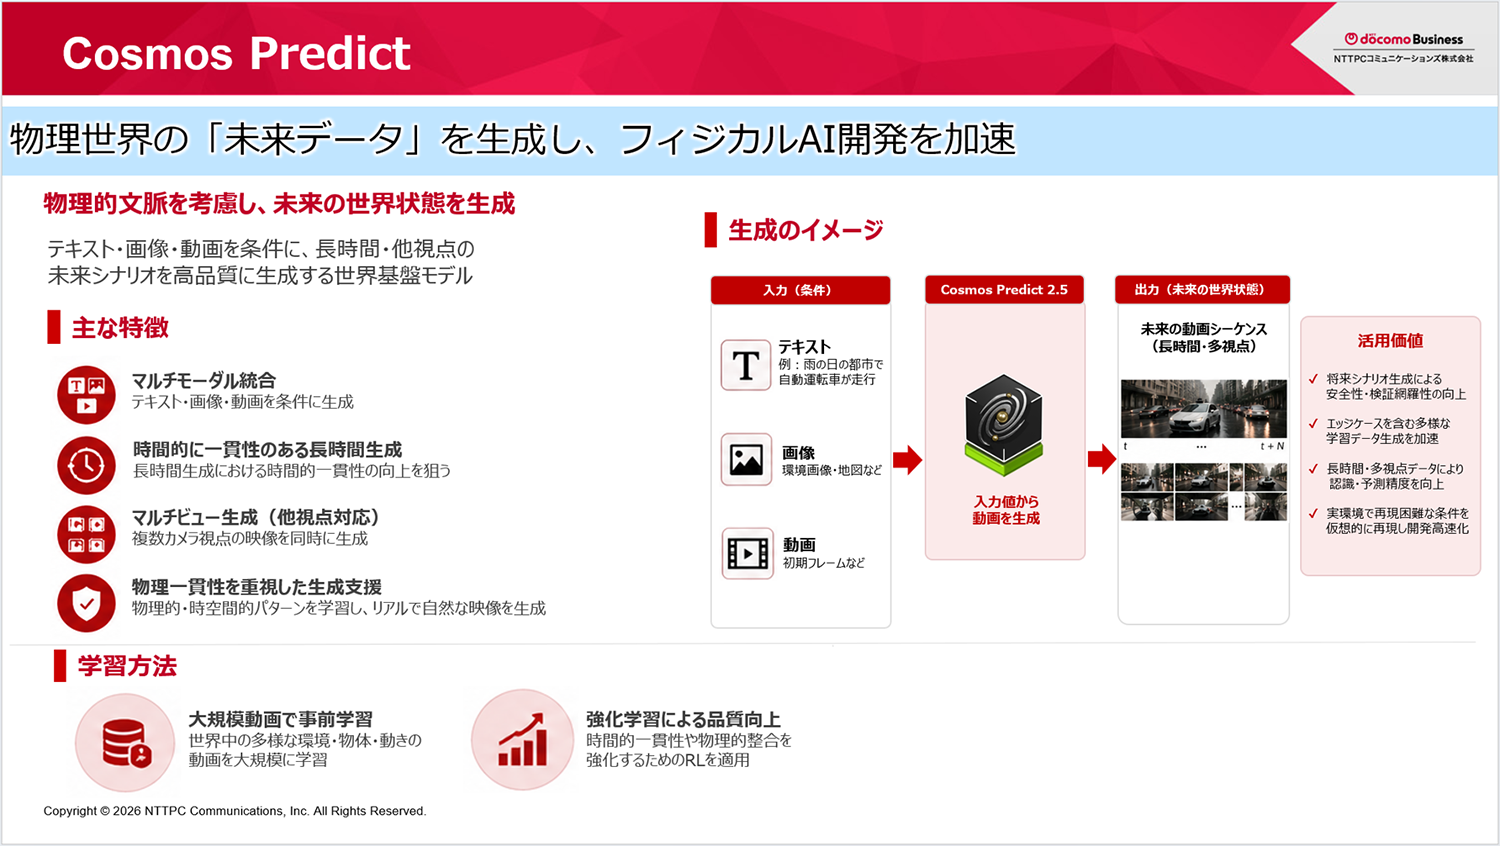
図3 Cosmos Predictによる未来映像候補の生成例。
Cosmos 3ではGenerator Towerが対応する世界生成機能を担う
また、配布されているモデルと生成AI向けプラットフォームを用いることで、Cosmos 3の世界生成機能を簡単に試すこともできます。以下はCosmos 3 NanoモデルとComfyUIを活用し、1枚の画像から結果が異なる複数の未来を生成した弊社検証例となります。
※同一の開始画像から異なるシナリオ条件で生成した定性的な例です。モデルによる安全判断・制御性能や、実世界での事象発生確率を評価した結果ではありません。
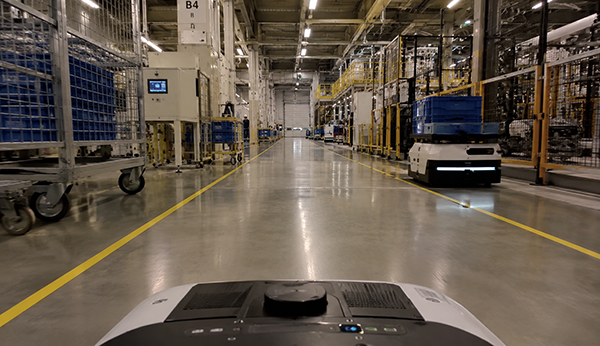
図4 スタート地点画像
図5 FutureA:通常走行を想定した生成シナリオ例
図6 FutureB:歩行者横断と減速・停止を想定した生成シナリオ例
図7 Future C:別AMRとの交差・譲りを想定した生成シナリオ例
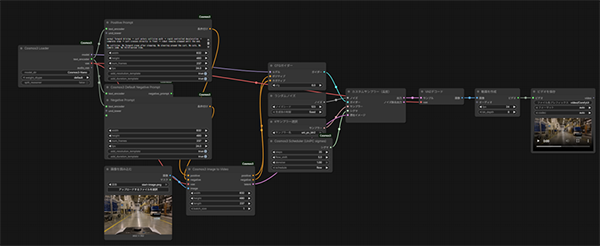
図8 ComfyUI Cosmos 3 I2Vワークフロー※
※本検証ではサードパーティ製の非公式カスタムノードを使用しています。
NVIDIA公式のCosmos 3主要integrationとは異なります
注意点
Cosmos 3は明示的な物理シミュレータではありません。生成・推論される物体運動、因果関係、3D形状、衝突、物体保持、長時間の時間的一貫性などは、学習データに基づく近似です。生成結果を物理的なGround Truthや安全性の保証として扱わず、物理シミュレータ、現実データ、安全制約を用いて別途検証する必要があります。
3. Controlled Generation:構造条件への整合を促しながら世界を変換・拡張する
シミュレーション環境では、物体の位置や深度、領域分割、姿勢、衝突情報など、学習・評価の基準となる正解データ(Ground Truth)を取得できます。一方、シミュレーション映像と現実のカメラ映像には、照明、質感、反射、ノイズ、センサー特性などの差があります。このようなシミュレーション環境と実環境の差は、一般にSim-to-Realギャップと呼ばれます。
Cosmos 2.xまでのCosmos Transfer系は、RGB映像に加え、深度、エッジ、セグメンテーション、visual-blurなどの構造的な制御情報を利用し、シミュレーションデータを現実に近いフォトリアルなデータへ変換するモデルでした。元シーンの構造条件への整合性を可能な限り保つよう条件付けながら、天候、照明、時間帯、質感などを変化させ、学習データの多様性を高めることを狙います。
Cosmos 3では、条件付き世界生成をGenerator Towerが担います。一方、Cosmos Transfer 2.5は、構造制御に特化した専用モデルとして併存しています。このため、Cosmos 3のGeneratorによる条件付き生成とTransfer 2.5の専用workflowは、同一のものとして扱わず、用途に応じて区別する必要があります。Cosmos 3の基盤アーキテクチャは、テキスト、画像、動画、音声、Actionなどの複数モダリティを扱います。ただし、利用可能な入出力の組み合わせは、モデル、checkpoint、NIM、runtimeによって異なります。
例えば、倉庫の構造条件への整合を促しながら照明や物体配置を変更する、走行シーンを雨天や夜間の表現へ変換するといったデータ拡張が考えられます。生成後には、入力した構造条件やActionとの整合性を確認する必要があります。したがって、Cosmos 3におけるTransfer相当の能力は、「指定された構造条件や物理的文脈への整合を促しながら、学習・評価に利用する世界のバリエーション候補を生成する機能」と言えます。
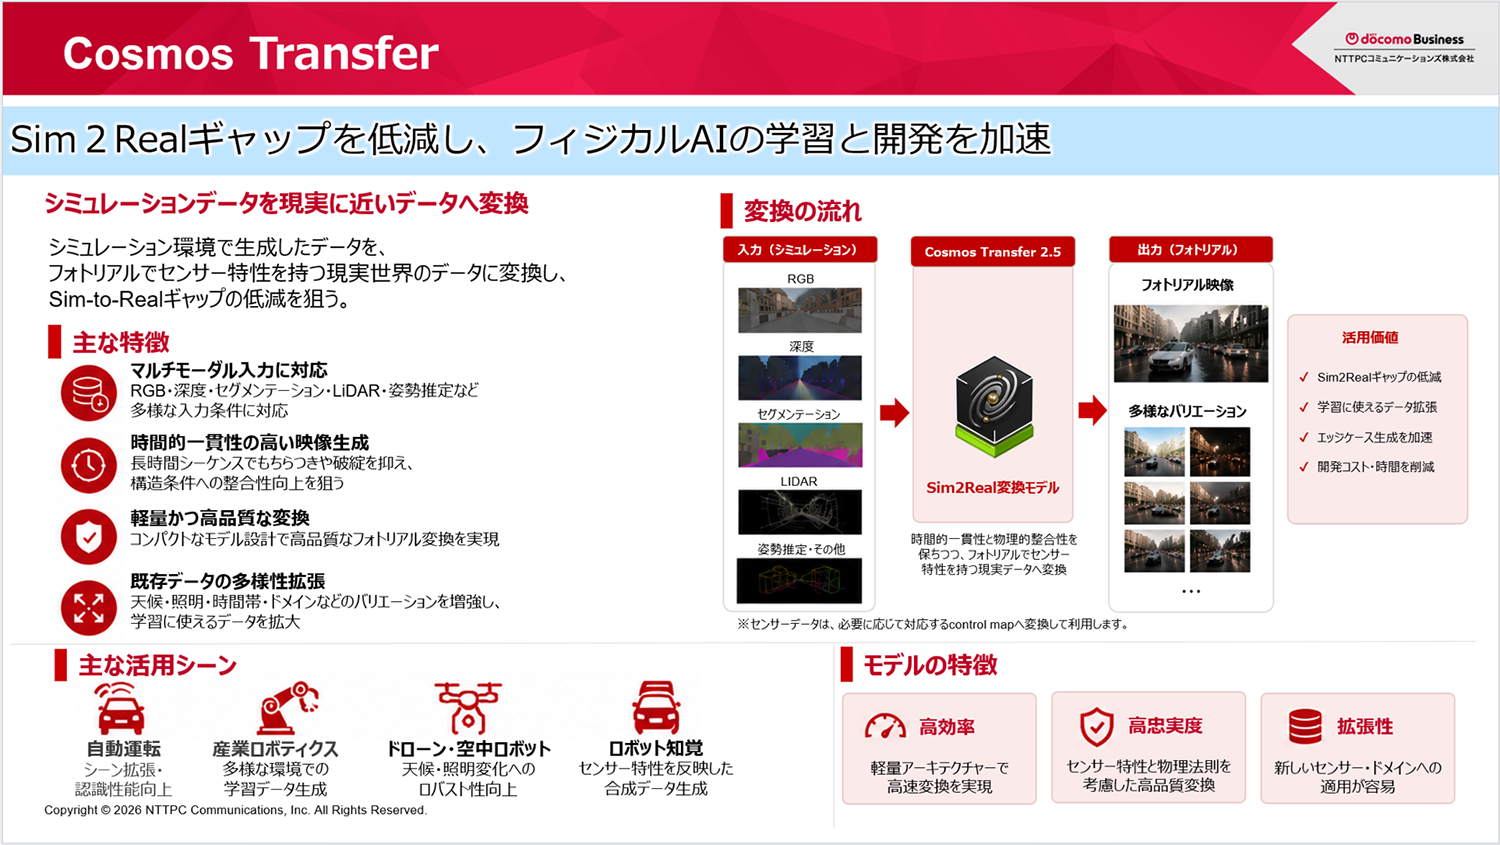
図9 Cosmos Transferによる構造条件付き映像生成の例。
Cosmos 3ではGenerator Towerが条件付き生成を担う一方、
Transfer 2.5も構造制御向けの専用モデルとして提供される
4. Action Generation:対象に応じたAction系列を生成する
Cosmos 3で特に重要な拡張点が、Actionをネイティブなモダリティとして扱う共通アーキテクチャです。行動生成そのものは、Cosmos-Predict2をロボットの実演データで追加学習したCosmos Policyや、その後のCosmos-Predict2.5を基盤とする行動条件付き生成および方策生成向けのモデルや追加学習ワークフローでも扱われていました。
Cosmos 3では、対応するAction表現とtask-specificなpost-trainingを用いることで、自然言語による行動提案に加え、対象となるロボットや車両が扱える形式のAction系列を生成できます。
Actionの表現は対象となるembodimentに依存します。例として、カメラや車両の移動軌跡、ロボットのend-effector pose、gripper stateなどが用いられます。実際の次元数、座標系、単位、制御周期、正規化方法は、使用するcheckpointと対象機器の仕様によって異なります。
例えば、対象物を把持して容器へ移すタスクでは、対象ロボットに対応したPolicy checkpointとAction表現を用いることで、接近、把持、持ち上げ、移動、配置に対応するAction系列を生成する用途が考えられます。
注意点
Cosmos 3におけるActionの意味や次元はembodimentに依存します。実機向けのend-effector pose、gripper state、移動軌跡などを生成する場合は、対象機器に対応したAction表現とpost-training/Policy checkpointが必要です。生成値を任意のロボットや車両へ直接入力できるわけではなく、安全制御と段階的な検証が別途必要です。
表 Action Generationにおける代表的なタスクと役割(当社調べ)
| 公開タスク | 入力と出力 | 想定する役割 |
|---|---|---|
| Forward Dynamics | 現在の観測+対象に対応したAction軌跡 → 将来観測の候補 | 入力したAction後に世界がどのように変化し得るかを近似的に予測 |
| Inverse Dynamics | 観測動画 → 対応するembodimentのAction表現による軌跡の推定結果 | 観測された状態変化に対応するAction軌跡を推定 |
| Policy Generation | 現在の画像+タスク指示+状態 → 将来観測と対象固有のAction系列(runtime/checkpoint依存) | task-specificなpost-trainingに基づき、タスク達成に向けたPolicyを生成 |
Cosmos 3は、世界の観測、物理的・時空間的関係の推論、将来観測の生成、Action Modelingを共通の基盤上で接続できます。
ただし、生成されたAction系列を任意の実機に直接入力できるわけではなく、安全性も保証されません。対象機器への座標変換、Action normalization、calibration、低レベルコントローラとの接続に加え、安全制約、独立した安全監視、フェイルセーフ、シミュレーション評価、リスク分析、段階的な実機検証が必要です。
5. 4つの能力を一つのオムニモーダル基盤で接続する
Cosmos 2.x系で提供されていたPredict、Transfer、Reasonは、Cosmosの主要な能力を理解するための分かりやすい分類です。一方、Cosmos 3の特徴は、ReasonerとGeneratorを組み合わせ、物理推論、世界生成、条件付き生成、行動生成を共通のオムニモーダル基盤上で接続できる点にあります 。
- 物理推論(Physical Reasoning):現在の観測から物体状態、動き、空間・時間関係、因果関係の候補を推論する
- 世界生成(World Generation):推論した文脈を条件として、将来状態の候補を生成する
- 条件付き生成(Controlled Generation):構造条件への整合を促しながら、環境バリエーションを生成する
- 行動生成(Action Generation):対象に応じた行動表現と追加学習を用いて、将来観測や行動系列を生成する
これらが固定された4段階の処理としてモデル内部を循環するわけではありません。実際のフィジカルAIシステムでは、Cosmos 3の推論・生成結果に、安全制約、シミュレーション、対象機器固有の低レベル制御、センサーからの再観測を組み合わせています。つまり、AIが観測し、推論・予測し、安全性を確認したうえで行動し、その結果を再び観測する、という閉ループを構成します。
なお、この閉ループ全体がCosmos 3内部だけで完結するわけではありません。
6. 動画生成を、フィジカルAIの学習・評価に活用する
Cosmosは動画を生成できますが、その目的は映像表現だけにとどまりません。生成した動画や将来観測を、フィジカルAIの学習、評価、世界予測、Action Modelingに活用することを想定しています。
重要なのは、見栄えのよい映像の生成だけを目的とせず、ロボットや自動運転AIの学習・評価に利用することを想定した、物体関係、動き、時間変化などの文脈を持つデータ候補を生成することです。Cosmos 3は、シーン内の物体関係、動き、時間変化などをReasoner Towerで推論し、その結果を条件として、動画、将来観測、Action系列を生成することを目指しています。
生成結果は安全を保証するものではありません。実機適用前には、シミュレーション評価、安全制約を持つ低レベル制御、独立した安全監視、フェイルセーフ、リスク分析、現実データとの照合、段階的な実機検証が必要です。実利用時には、使用するモデルおよびコードのライセンス、入力画像・動画の利用権、個人情報、肖像、知的財産、対象システムに適用される安全規格を個別に確認する必要があります。
7. まとめ:Cosmos 3が変えるフィジカルAI開発
本記事では、フィジカルAIにおけるデータ不足の課題と、それを支えるNVIDIA Cosmos 3の役割を紹介しました。
従来のCosmos 2.xでは、未来を生成するPredict、シミュレーションデータを現実に近づけるTransfer、物理世界の関係を推論するReasonという分類が用いられていました。Cosmos 3では、これらの能力をReasoner TowerとGenerator Towerからなる共通のオムニモーダル基盤上で接続できるようになりました。
Cosmos 3は、テキスト、画像、動画、音声、Actionといった複数のモダリティを共通のアーキテクチャで扱うオムニモーダルな世界基盤モデルです。ただし、利用可能な入出力の組み合わせは、モデル、checkpoint、NIM、runtimeによって異なります。
これにより、物理世界に関する時空間的・物理的パターンを推論し、未来状態や環境バリエーションを生成するだけでなく、対象機器に対応したAction表現とpost-trainingを用いることで、移動軌跡、end-effector pose、gripper stateなどのAction系列も扱えるようになりました。Cosmos 3は、フィジカルAIに必要な物理推論、世界予測、条件付き生成、Action Modelingを、共通のオムニモーダル基盤上で接続できるモデルへ進化したといえます。
一方、生成されたデータやAction系列をそのまま実機へ適用できるわけではありません。生成結果は物理的なGround Truthではなく、Actionの意味や次元も対象機器に依存します。実用化には、シミュレーション評価、安全制約を持つ低レベル制御、独立した安全監視、フェイルセーフ、リスク分析、現実データとの比較、段階的な実機検証が必要です。
フィジカルAIは、AIモデルだけでなく、GPU基盤、シミュレーション、センサー、制御、安全設計を横断して取り組む必要があります。まずは対象となる環境やタスクを限定した小規模な検証から始め、知見を蓄積していくことが重要です。
NTTPCコミュニケーションズでは、GPU基盤の設計・構築・運用で培った知見を生かし、CosmosをはじめとするフィジカルAI関連技術の検証を進めています。今後も、検証を通じて得られた知見や課題を発信していきます。
▶︎ お問い合わせはこちら
※本記事に掲載している内容は、2026年8月時点での情報をもとに作成しています。
※「NVIDIA」「NVIDIA Cosmos」「NVIDIA NIM」は米国およびその他の国における NVIDIA Corporation の商標または登録商標です。