

基礎知識
NVIDIA Vera Rubin プラットフォームとは?次世代AIファクトリー基盤の構成と進化
2026.09.30

GPUエンジニア

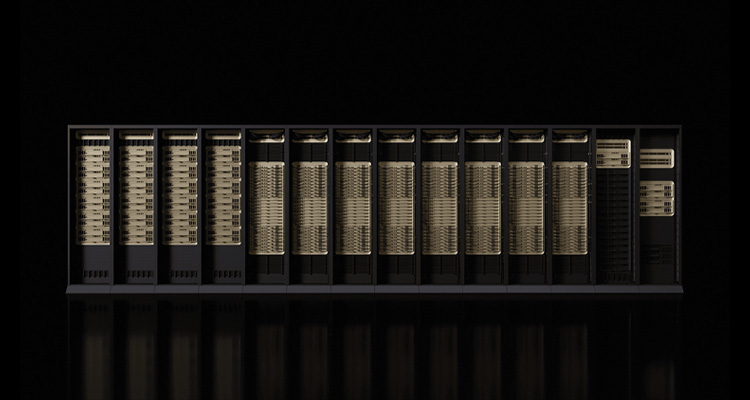
NVIDIA®は2026年1月のCESで、NVIDIA Blackwell世代の後継となる次世代AIファクトリー基盤「NVIDIA Vera Rubin プラットフォーム」 を発表しました。続く3月のGTC 2026では、低遅延推論を担うNVIDIA Groq 3 LPUを7番目のチップとして加えた PODスケールシステムへの移行として、「7チップ・5種類のラックスケールシステム」の構成が提示されています。
本記事では、CES発表時の6チップとNVIDIA Groq 3 LPUを含む現行のVera Rubinの POD構成、その中核となるNVIDIA Vera Rubin NVL72、AIファクトリー全体のリファレンスデザインであるNVIDIA DSX™、次世代のNVIDIA Rubin Ultra NVL576など、Rubin世代のプラットフォームを解説します。
【目次】
- NVIDIA Vera Rubin プラットフォームとは:次世代AIファクトリー基盤の全体像
1-1. Blackwell世代からの進化と位置づけ - Vera Rubin プラットフォーム本体を構成する6つの新チップとNVIDIA Groq 3 LPU
2-1. Rubin GPU:NVFP4推論を担う中核GPU
2-2. Vera CPU:制御・データ処理を支える88コアArm系CPU
2-3. NVLink 6 スイッチとConnectX-9 SuperNIC
2-4. BlueField-4 DPUとSpectrum-6 イーサネット スイッチ - ラックスケール構成の中心:Vera Rubin NVL72
3-1. 72 Rubin GPU+36 Vera CPUを単一ドメインで束ねるラック設計
3-2. 第6世代NVLinkがもたらす260 TB/sの統合インターコネクト
3-3. Blackwell世代に対する推論性能・トークン単価の改善 - AIファクトリー全体の設計とロードマップ:Vera Rubin DSX
4-1. 推論データプレーンを担うBlueField-4 STXとCMX
4-2. 5種類のラックスケールシステムの役割分担とVera Rubin DSX
4-3. Vera Rubin Ultra NVL576とNVIDIA Kyber:複数ラックを単一ドメインで束ねる構想
4-4. Rubin CPXとVera Rubin NVL144 CPX:長コンテキスト推論・生成動画向けの並列ライン - Vera Rubin プラットフォーム導入・移行時の確認ポイント
5-1. 電力・冷却設計の事前確認 - まとめ
1. NVIDIA Vera Rubin プラットフォームとは:次世代AIファクトリー基盤の全体像
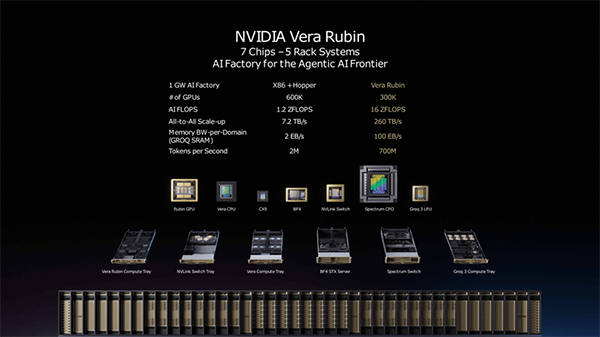
NVIDIA Vera Rubin プラットフォームは、NVIDIA Vera CPU ・ NVIDIA Rubin GPUを中心とする6つの新チップと、低遅延推論を担うNVIDIA Groq 3 LPUを組み合わせた、計7チップ構成の次世代AIファクトリー基盤です。Vera Rubin PODでは、5種類のラックスケールシステムを束ねることで、事前学習(pretraining)、事後学習(post-training)、推論時スケーリング(test-time scaling)、エージェント型スケーリング(agentic scaling)までをPODスケールで支えます。
特に、Agentic AI(自律的に多段階の推論とツール呼び出しを行うAI)の本格運用と、推論時の動的なスケーリングが大きな強みです。
1-1. Blackwell世代からの進化と位置づけ
Vera Rubin プラットフォームは、NVIDIAが現在提供しているBlackwell世代(B200・GB200 NVL72など)の後継として位置づけられる、AIファクトリー基盤の新しい世代です。
Blackwell世代で導入された数値精度NVFP4(NVIDIA Floating Point 4:4ビット浮動小数点フォーマット)を、Rubin GPUの新Transformer Engineと、「hardware-accelerated adaptive compression」と呼ばれるアダプティブ圧縮の仕組みでさらに強化し、あわせてVera CPU・NVIDIA® BlueField®-4 DPU・NVIDIA Spectrum-6 イーサネット スイッチなどを含めて、AIファクトリーを構成するチップ群そのものが新世代に置き換わります。
Vera Rubin NVL72はBlackwell プラットフォーム比の改善も示されており、推論スループット・電力効率・MoEモデル(Mixture of Experts:専門家混合モデル は、AIモデル内部に複数の「専門家(Expert)」ネットワークを用意し、入力ごとに必要な専門家だけを動作させるアーキテクチャ)です。より大規模・高密度なAIファクトリーへ向けた選択肢として位置づけられる点が特徴です。
2. Vera Rubin プラットフォーム本体を構成する6つの新チップとNVIDIA Groq 3 LPU
Vera Rubin プラットフォームは、AIファクトリーをチップから設計するための統合基盤で、Vera CPU・Rubin GPUを中心とする本体の6つの新チップ(2026年1月CES発表時の構成)に、7番目のチップとなる低遅延推論アクセラレータのNVIDIA Groq 3 LPUを合わせて、Vera Rubin POD全体を構成します。
本セクションでは本体の6チップを役割別に整理します。
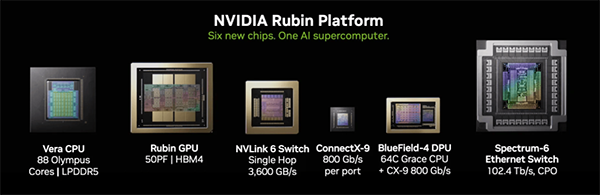
| チップ | 主な役割 | 配置 |
|---|---|---|
| NVIDIA Vera CPU | AIワークロードの制御・データ処理を担う88コアのArm系CPU | NVL72ラック内(GPUとペア)・Vera CPU rack |
| NVIDIA Rubin GPU | NVFP4精度の推論・学習を担う中核GPU | NVL72ラック内 |
| NVIDIA NVLink™ 6 スイッチ | 72基のGPUを単一ドメインで束ねる第6世代インターコネクト | NVL72ラック内 |
| NVIDIA® ConnectX®-9 SuperNIC™ | ラック間・ノード間のRDMA通信を担う高速NIC | NVL72・周辺ラック |
| NVIDIA BlueField-4 DPU | KVキャッシュオフロード・ストレージ加速・セキュリティ処理を担うDPU | Vera Rubin NVL72・Vera CPU rack・NVIDIA Groq 3 LPU・BlueField-4 STX |
| NVIDIA Spectrum-6 イーサネット スイッチ | AIファクトリー全体のスケールアウトを支える102.4 Tb/s級Ethernetスイッチ | Spectrum-6 SPXラック |
これら6つの新チップは、NVIDIA Groq 3 LPUを加えた7チップとして、NVIDIAが「5 Rack Systems」と呼ぶ5種類の役割別ラックスケールシステムに統合されます。
各ラックスケールシステムの詳細は後段の「5種類のラックスケールシステムの役割分担」で扱います。
2-1. Rubin GPU:NVFP4推論を担う中核GPU
NVIDIA Rubin GPUは、Vera Rubin プラットフォームの演算性能を支える中核GPUです。新しいTransformer Engineと「hardware-accelerated adaptive compression」によって、NVFP4精度のスループットを底上げします。
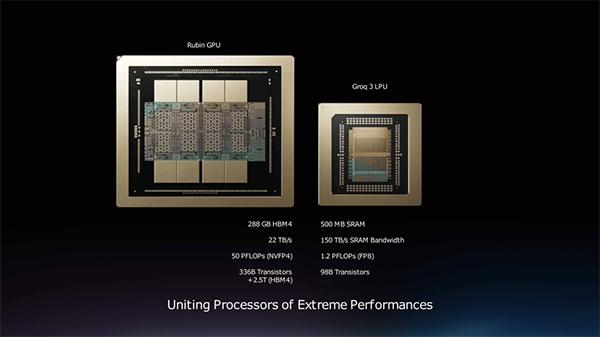
左:NVIDIA Rubin GPU、右:NVIDIA Groq 3 LPU。
Vera Rubin POD構成で演算性能を支える中核GPUと低遅延推論アクセラレータ
(引用:NVIDIA GTC 2026 Keynote)
Rubin GPUの代表的な仕様は以下の通りです。
- NVFP4精度で最大50 petaFLOPS(PFLOPS)の推論性能(GPU単体・NVIDIA公表値)
- 新Transformer Engineによるアダプティブ圧縮でNVFP4のスループットを底上げ
- NVLink-C2CによるVera CPUとの密結合で、ホスト〜GPU間のデータ転送ボトルネックを軽減
これにより、トークンあたりの計算コストを下げつつ推論品質を保つことを狙いとしています。
2-2. Vera CPU:制御・データ処理を支える88コアArm系CPU
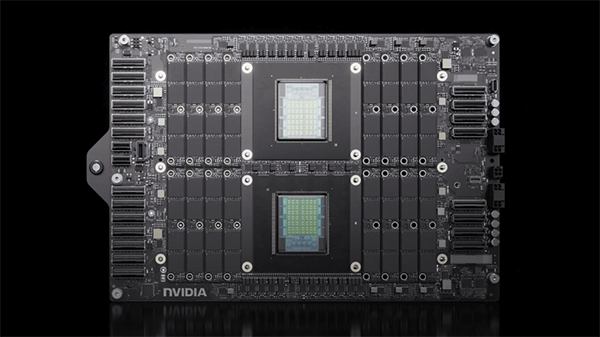
NVIDIA Vera CPUは、NVIDIAが自社設計するデータセンター向けArmコアベースのCPUで、Vera Rubin プラットフォームにおいては、Rubin GPUへのデータ供給・タスク制御・前処理を担うホスト側プロセッサとして位置づけられています。
Vera CPUの主な仕様は以下の通りです。
- 88コアのNVIDIA自社設計コア(Arm互換)
- 1基あたり最大1.2 TB/sのLPDDR5Xメモリ帯域
- NVLink-C2C(GPU・CPU間を直接結ぶコヒーレントなチップ間接続)によるGPUとの密結合
- Vera CPU rackとして最大256基規模で集約し、強化学習・エージェント環境を多数並列に動かす用途にも対応
数千台のGPUを効率的に運用するためには、ノード内のデータ、メモリ、制御が遅延なく流れることが非常に重要です。Vera CPUは、従来の汎用ホストCPUとしての役割を果たすだけでなく、GPUとトレーニングや推論環境で発生するCPU側のボトルネックを除去し、持続的な高い利用率を実現します。
2-3. NVLink 6 スイッチとConnectX-9 SuperNIC
ラック内のスケールアップを担うNVLink 6 スイッチと、ラック間のスケールアウトを担うConnectX-9 SuperNICは、Vera Rubin プラットフォームの通信設計の中核です。
- NVLink 6 スイッチ :72基のRubin GPUを単一ドメインで束ねる第6世代NVLinkのスイッチIC。
- ConnectX-9 SuperNIC :ラック内・ラック間のRDMA(Remote Direct Memory Access通信:CPUやOSをほとんど介さずに、あるサーバーのメモリへ別のサーバーが直接アクセスできる通信技術)通信を担う高速NIC。Spectrum-X イーサネット・NVIDIA Quantum-X800™ InfiniBandと組み合わせて、AIファクトリー全体のスケールアウトを可能にする。
NVLink・NVスイッチの仕組みと世代別の帯域については、以下の記事で詳しく整理しています。
▶︎ マルチGPU環境構築の鍵!NVLinkとNVSwitchが実現する超高速データ伝送とは
2-4. BlueField-4 DPUとSpectrum-6 イーサネット スイッチ
BlueField-4 DPUとSpectrum-6 イーサネット スイッチは、AIファクトリーの「データプレーン」と「スケールアウトネットワーク」の役割を果たします。
- BlueField-4 DPU:ネットワーク・ストレージ・セキュリティ処理をGPUからオフロードするDPU。後述するNVIDIA® CMX™(Context Memory eXtension / Context Memory Storage) は、AI推論時に生成される KVキャッシュ(Key-Value Cache) を保存・共有するためのAIネイティブなストレージプラットフォーム)のホストプロセッサも務める
- Spectrum-6 イーサネット スイッチ:102.4 Tb/s帯域・512レーン・200 Gb/sのco-packaged opticsを統合したEthernetスイッチICで、Spectrum-6 SPXラックとしてVera Rubin POD全体のスケールアウトネットワークとなる
3. ラックスケール構成の中心:Vera Rubin NVL72
Vera Rubin NVL72は、72基のRubin GPUと36基のVera CPUを第6世代NVLinkで「単一の巨大GPU」として動作させるラックスケールシステムで、AIファクトリーのコンピュート層の中核です。
3-1. 72 Rubin GPU+36 Vera CPUを単一ドメインで束ねるラック設計
Vera Rubin NVL72は、1ラックあたり72基のRubin GPUと36基のVera CPUを搭載し、NVLink 6 スイッチで密結合した構成です。CPUとGPUは1:2の比率(1基のVera CPUに対して2基のRubin GPU)で組み合わされ、それぞれNVLink-C2Cでコヒーレント接続されます。
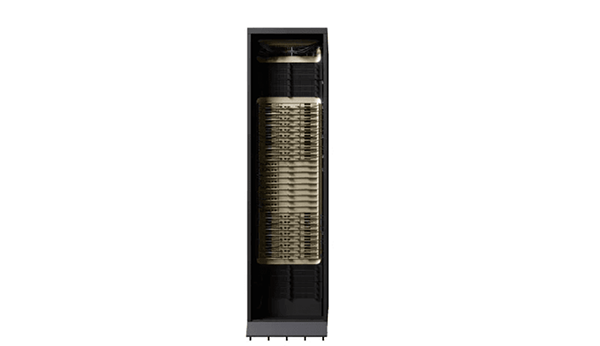
ラック内には、GPU・CPUに加えてConnectX-9 SuperNICとBlueField-4 DPUも統合され、ノード間通信とストレージ・セキュリティ処理を行う構成になっています。GB200 NVL72と同様、ラック単位での液冷を含む高密度設計となっており、AIファクトリーの処理速度を大きく引き上げます。
3-2. 第6世代NVLinkがもたらす260 TB/sの統合インターコネクト
Vera Rubin NVL72のもうひとつの中心は、第6世代NVLink(NVLink 6)による超高速インターコネクトです。GPUあたり3.6 TB/sのNVLink帯域、ドメイン全体で260 TB/sの接続性を備え(第5世代NVLinkに対しGPU当たり帯域が2倍)、72基のRubin GPUを単一の演算ドメインとして扱えます。さらにNVIDIA SHARP(Scalable Hierarchical Aggregate and Reduction Protocol)はNVIDIA InfiniBandネットワークに実装された In-Network Computing(ネットワーク内演算)技術 。集合通信の一部をネットワーク/インターコネクト内で処理するIn-Network Computing技術です。NVLink 6ではSHARPがNVLink fabricに統合され、all-reduce、reduce-scatter、all-gatherの一部をスイッチ内で処理します。「All-reduce通信量を最大50%削減できる」とNVIDIAは説明しています。
第6世代NVLinkは「単一の性能ドメイン(single performance domain)」としてGPU群を扱える点が重要で、分散学習や大規模推論で性能のボトルネックになりがちなGPU間通信オーバーヘッドの最小化を目指しています。
3-3. Blackwell世代に対する推論性能・トークン単価の改善
NVIDIAは、Vera Rubin NVL72とBlackwell プラットフォームを比較した次の改善効果を公表しています。
| 比較項目 | 改善幅 |
|---|---|
| 推論スループットあたりの電力効率 | Blackwell プラットフォーム比で最大10倍 |
| トークンあたりコスト | Blackwell プラットフォーム比で約10分の1 |
| MoEモデルの学習に必要なGPU数 | Blackwell プラットフォーム比で4分の1 |
| 組立・保守性(compute tray設計改善) | Blackwell世代比で最大20倍 |
興味深いのは「組立・保守性」も最大20倍向上するという点です。これは、ケーブルフリー・ホースフリー・ファンレスを徹底したコンピュートトレイ設計(AIサーバーやラックスケールシステムにおいて、CPU・GPU・メモリ・NICなどの計算リソースを1つの引き出し(トレイ)状のモジュールに集約し、それをラックへ搭載する設計方式)によるもので、コンピュートトレイの組立時間が「Blackwellでは約2時間かかっていたものが、Vera Rubinでは約5分」まで短縮されると説明されています。データセンター運用におけるラック展開・部品交換・メンテナンス時間の圧縮に直結する大きな改善です。
加えて第3世代コンフィデンシャルコンピューティング※により、ラック全体(72 Rubin GPU・36 Vera CPU・NVLinkファブリック)を統一されたTrusted Execution Environmentとして扱えます。比較スコープは「Vera Rubin NVL72(ラック単位) vs Blackwell プラットフォーム」であり、GPU単体同士の比較ではない点と、ワークロード条件・構成により実測値が変動する点に注意が必要です。
※コンフィデンシャルコンピューティング:「処理中のデータ」まで暗号保護する技術であり、AI時代のクラウド利用において機密データやAIモデルを安全に扱うための重要な基盤技術
4. AIファクトリー全体の設計とロードマップ:Vera Rubin DSX
Vera Rubin プラットフォームは、チップやラックの集合体としてだけでなく、AIファクトリー全体を設計するためのリファレンスとしても整備されています。本セクションでは、推論データプレーンを担うBlueField-4 STXとCMX、5種類のラックスケールシステムの役割分担、Vera Rubin DSXの位置づけ、その先に控えるRubin Ultra NVL576・NVIDIA Kyber の構想、そして長コンテキスト推論向けに別ラインで進むNVIDIA Rubin CPX/NVL144 CPXまでを紹介します。
4-1. 推論データプレーンを担うBlueField-4 STXとCMX
LLM推論では、過去トークンの計算結果を保持するKVキャッシュ(LLMが推論時に生成した中間計算結果を保存し、同じ計算を繰り返さないようにする仕組み)がGPUメモリを大きく消費し、コンテキスト長(Context Length:AIモデルが一度に記憶・参照できる入力と出力の総トークン数)が長くなるほど肥大化します。Vera Rubin プラットフォームではNVIDIA CMX(Context Memory Storage)と呼ばれるAIネイティブなストレージ基盤がこの課題に対応します。
CMXはBlueField-4 DPUをホストプロセッサとして、KVキャッシュを高帯域ストレージ層に保存・共有する仕組みで、従来のストレージアプローチに比べトークン毎秒スループット・電力効率ともに最大5倍に改善されるとNVIDIAは説明しています(参考:NVIDIA Newsroom)。
BlueField-4にはさらにNVIDIA BlueField Astra(Advanced Secure Trusted Resource Architecture)が組み込まれ、Vera Rubin NVL72のコンピュートトレイ内でDPUを信頼された制御点として機能させます。これにより、プロビジョニングやポリシー適用、SuperNIC制御をホストOSから分離し、マルチテナント環境でのセキュアな運用を支えます。また、Vera Rubin NVL72は第3世代コンフィデンシャルコンピューティングにより、ラックレベルのTrusted Execution Environment(TEE:信頼実行環境:CPUやGPUの中に作られる隔離された安全な実行領域)を支える設計です。
CMXを担うBlueField-4 STXはAIネイティブなストレージラックとして提供され、Vera Rubin NVL72・Vera CPU rack・NVIDIA Groq 3 LPX・Spectrum-6 SPXとともに、Vera Rubin PODを構成する5種類のラックスケールシステムの一つに位置づけられます。
4-2. 5種類のラックスケールシステムの役割分担とVera Rubin DSX
Vera Rubin POD全体は、コンピュート・CPU集約・ストレージ・ネットワーク・低遅延推論をそれぞれ担う、次のような5種類のラックスケールシステムで構成されます。まず各ラックスケールシステムの役割を確認し、そのうえでVera Rubin DSXがそれらをAIファクトリー全体の設計単位として統合する関係性を整理します。
| ラックスケールシステム | 役割 | 主な搭載要素 |
|---|---|---|
| Vera Rubin NVL72 | コンピュート(AI推論・学習の中核) | 72 Rubin GPU + 36 Vera CPU + ConnectX-9 + BlueField-4 |
| Vera CPU rack | CPU集約処理(強化学習・エージェント環境) | 最大256基のVera CPU・液冷ラック |
| BlueField-4 STX | AI-nativeストレージ(CMXコンテキストメモリ) | BlueField-4多数 + 高帯域ストレージ |
| Spectrum-6 SPX | スケールアウトネットワーク | Spectrum-X イーサネット スイッチまたはNVIDIA Quantum-X800 InfiniBand スイッチで構成 |
| NVIDIA Groq 3 LPX | 低遅延推論アクセラレータ | NVIDIA Groq 3 LPU × 256基(ラックあたり) |
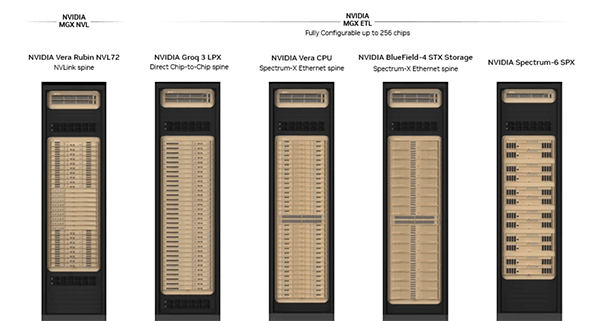
コンピュート・CPU・ストレージ・ネットワーク・低遅延推論をそれぞれ独立した役割のラックスケールシステムとして切り分け、NVIDIA Groq 3 LPUを加えた「7チップ × 5種類のラックスケールシステム」として示されています。Vera Rubin POD単体は、40ラック構成で1,152基のRubin GPU・60 EFLOPS(NVIDIA公表値)・総スケールアップ帯域10 PB/sを単一のAIスーパーコンピュータとして束ねる仕様です。
さらにNVIDIAは、GTC 2026の基調講演内の「1 GW AI Factory」の世代スライドにおいて、X86+Hopperの600K GPU/1.2 ZFLOPS構成に対し、Vera Rubin世代では同じ1 GWでGPU数を300Kへ半減しつつ、AI FLOPSを16 ZFLOPSへ拡大する構成を示しています。
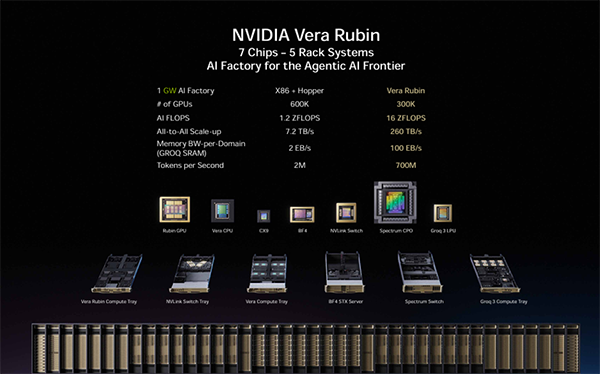
これはPOD単体ではなく、1 GW級AIファクトリー全体の比較であり、PODの仕様値(1,152 GPU/60 EFLOPS)とは異なるスコープの数値です(出典:NVIDIA「NVIDIA Vera Rubin POD」)。
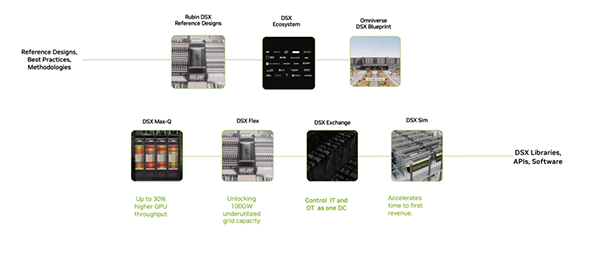
そのうえで、これら5種類のラックスケールシステムをAIファクトリー全体の設計単位として統合するのがVera Rubin DSXです。NVIDIAはDSXを「AIファクトリーのブループリント/リファレンスデザイン」と位置づけ、チップ・システム・ソフトウェアライブラリ・API・パートナーエコシステムまでを束ねて「チップから電力グリッドまでをcodesign(共同設計)する」ことを目指しています。設計目標は「グリッド電力あたりの有効トークン生成効率(Goodput)」の最大化で、AIファクトリーの消費電力・冷却・ラック構成までを一体で設計する単位として位置づけられます。
4-3. Vera Rubin Ultra NVL576とNVIDIA Kyber:複数ラックを単一ドメインで束ねる構想
Vera Rubin プラットフォームの先には、さらに大規模なスケールアップ構想が控えています。中心となるのがVera Rubin Ultra NVL576と、新しいNVIDIA MGX™ラック設計であるNVIDIA Kyberです。
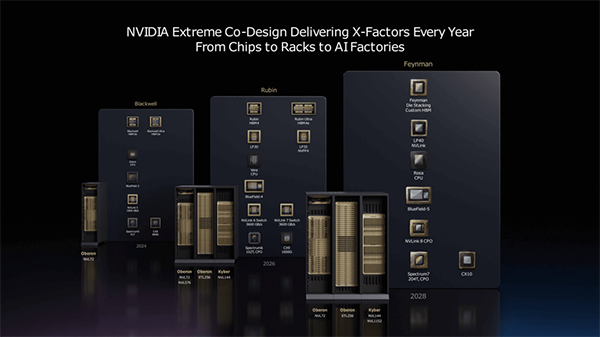
NVIDIAが示すチップ・ラック・AIファクトリーのロードマップ。
Blackwell→Rubin→Feynmanの3世代を3層で並列に進化させる
(引用:NVIDIA GTC 2026 Keynote)
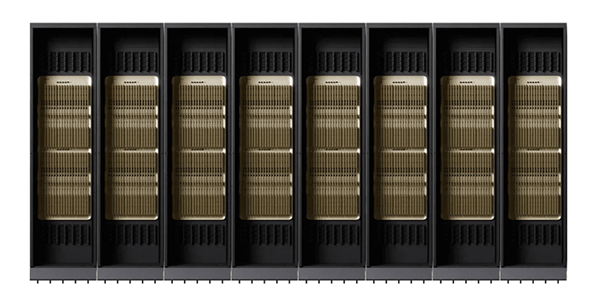
Vera Rubin Ultra NVL576は、Rubin Ultra GPUを576基まで単一NVLinkドメインで束ねるラックスケールシステムで、8つのMGX NVLラック(各72基のRubin Ultra GPU搭載)を組み合わせて構成されます。NVL72が「1ラックを1つの巨大GPU」として扱う設計だとすれば、NVL576は「複数ラックを1つの超巨大GPU」として扱う構想です。
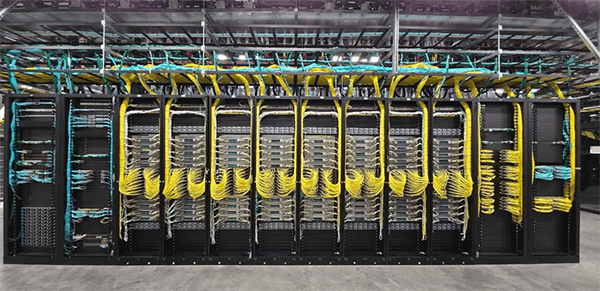
その先のラック設計として示されているのがNVIDIA Kyberで、現行のMGX NVLラック(Oberon)よりも1ラックあたりのNVLinkドメインを144 GPUまで拡張します。これにより、Oberon系のNVL72/NVL576に加えて、Kyber系のNVL144、さらに将来的なNVL1152という複数のスケール規模が、用途に応じて選べる形になります。
ラック間相互接続はCopper(銅配線)とDirect optical(直接光接続)を併用し、ラック内距離の短さを活かしたCopperと、ラック間の長距離を支える光接続を使い分ける設計です。
4-4. Rubin CPXとVera Rubin NVL144 CPX:長コンテキスト推論・生成動画向けの並列ライン
NVIDIAは2025年9月のAI Infra Summitで、Vera Rubin プラットフォーム本体とは別ラインとして Rubin CPX を発表しています。Rubin CPXは「CUDA® GPUとしては初めて、massive-context AI(百万トークン級の超長コンテキスト処理)を主目的に設計された新クラスのGPU」と位置づけられ、ビデオエンコーダ・デコーダを内蔵し、生成動画や大規模コード生成のように長コンテキストと動画処理が同時に要求されるワークロードに最適化されています。
Rubin CPXをラックスケールに束ねた構成が Vera Rubin NVL144 CPX で、NVIDIAは「1ラックで8 EFLOPS級のAI演算性能・100 TBの高速メモリ・1.7 PB/sのメモリ帯域を備え、GB300 NVL72比で約7.5倍のAI性能を発揮する」と説明しています。
ここまで見てきたVera Rubin NVL72/NVL576/Kyberが汎用的なAI演算密度を引き上げる方向であるのに対し、Rubin CPX/NVL144 CPXは「長コンテキスト推論」「生成動画」「百万トークン級コード生成」といった特定用途向けに最適化された並列ラインに位置づけられます。
導入検討時は、汎用ワークロードはNVL72/NVL576系、長コンテキスト推論・生成動画系はNVL144 CPX系という形で、ワークロード性質に応じた選定軸が一つ増える点を踏まえておく必要があります。
5. Vera Rubin プラットフォーム導入・移行時の確認ポイント
Vera Rubin プラットフォームは、Blackwell世代と比較してもラック構成・冷却・ネットワーク要件が大きく変わる基盤です。
実際に導入や既存環境からの移行を検討する際には、「電力・冷却の設計」と「既存環境からの移行とGPU構成別の選定目安」の2点を事前に整理しておく必要があります。
5-1. 電力・冷却設計の事前確認
Vera Rubin NVL72やVera CPU rackはラック単位で高密度に構成されるため、NVIDIAが想定する、最大45℃の液体入口温度に対応する単相直接液冷(DLC)を前提とした電力・冷却設計の確認が必要です。ラック導入を検討する際は、次の項目を事前に確認しておくと良いでしょう。
- ラックあたりの想定電力規模と、配電・PDU(Power Distribution Unit:データセンターやラック内で電力を各装置へ分配するための配電装置)の仕様
- 直接液冷(DLC)に対応する冷却インフラの有無と更新計画
- ラック単位での給排水・配管経路、漏水検知などの運用設計
- 既存データセンターの床荷重・天井高・空調容量との整合
6. まとめ
NVIDIA Vera Rubin プラットフォームは、7つの新チップと5種類のラックスケールシステムを統合し、事前学習からエージェント型推論までを支える次世代AIファクトリー基盤です。
Vera Rubin POD(7チップ・5種類のラックスケールシステム)を中核に、コンピュートの中核となるVera Rubin NVL72、AIネイティブストレージを担うBlueField-4 STX/CMX、AIファクトリー全体のリファレンスデザインであるVera Rubin DSX、次世代のRubin Ultra NVL576、そして長コンテキスト推論向けに別ラインで進むRubin CPX/NVL144 CPXまでを視野に入れています。Agentic AIや推論時スケーリングなど、トークン消費が大きく動的に変動する推論系ワークロードへの対応で「より少ないGPUで、より多くのトークンを生成する」ことが圧倒的な効率性とコストパフォーマンスが訴求点となっています。
Vera Rubinはフルプロダクションへのランプ段階に入り、2026年後半からはパートナー経由でのVera Rubinベース製品の本格提供が徐々に進むとされています。(2026年8月時点の情報)
選定検討は「将来構想」から「実機を前提とした構成検討」へとフェーズが移りつつあり、検証段階のワークステーションから、部門単位のNVL72、全社・サービス基盤としてのVera Rubin POD、そしてRubin Ultra NVL576・長コンテキスト推論向けのNVL144 CPXまで、ワークロード性質と導入規模に応じた段階的な拡張パスが示されています。
NTTPCは、NVIDIAエリートパートナーとして、GPUクラスタの構築や、電力・冷却を含む物理インフラ設計までを一貫して支援します。ご検討の際はお気軽にご相談ください。
▶︎ お問い合わせはこちら
※NVIDIA、NVIDIA Blackwell、NVIDIA Vera Rubin、NVIDIA Vera Rubin プラットフォーム、NVIDIA Groq 3 LPU、NVIDIA Vera Rubin NVL72、NVIDIA DSX™、NVIDIA DSX、NVIDIA Rubin Ultra NVL576、NVIDIA Rubin、NVIDIA Vera、NVIDIA Vera CPU、NVIDIA Rubin GPU、NVIDIA BlueField-4 DPU、NVIDIA Spectrum-6、NVIDIA Spectrum-6 Ethernet Switch、NVIDIA NVLink、NVIDIA NVLink 6 Switch、NVIDIA ConnectX®-9 SuperNIC™、NVIDIA ConnectX、Spectrum-X、NVIDIA Quantum-X800、NVIDIA BlueField、NVIDIA Spectrum、NVIDIA CMX、NVIDIA BlueField-4 STX、NVIDIA Kyber、NVIDIA Rubin CPX、NVIDIA NVL144 CPX、NVIDIA Spectrum-X、NVIDIA CUDA は、米国およびその他の国におけるNVIDIA Corporationの商標または登録商標です。