

基礎知識
GPUインフラの選び方:国内クラウド・海外クラウド・オンプレミスを比較
2026.09.30

GPUエンジニア

生成AIやLLM(大規模言語モデル、以下LLM)の開発・運用でGPUクラウドの利用が広がる一方、実運用に入ると長期稼働で膨らむ総額、想定外に積み上がるデータ転送料、利用期間中の料金改定、海外リージョン利用時のデータ主権など、当初のコスト試算に収まらないこともあります。
加えて、主要パブリッククラウド事業者ではH200やBlackwell系GPUの提供が広がり、GPU世代・スペックだけでは差がつきづらくなっています。これからGPUインフラを選ぶ際の判断軸は、次の2つに集約されつつあります。
- 軸①:データをどこに置くか(国内 / 海外 / 自社)――データ主権・契約/法令上の要件・データ転送料金の条件に関わる
- 軸②:どう調達するか(時間課金 / 月額課金 / 購入)――総額の読みやすさ・常時稼働時の単価・初期投資とTCOのバランスに関わる
この2軸を切り分けずに決めると、データの取り扱い要件を満たせなかったり、長期稼働時の総額が想定を上回ったりする可能性があります。2軸を並べて比較することで、要件に合う配置先と調達方法を選びやすくなります。
本記事では、国内クラウド・海外大手ハイパースケーラー3社(AWS、Azure、Google Cloud など)・オンプレミスを整理し、それぞれの立ち位置と、NTTPCコミュニケーションズが提供するGPUクラウド・オンプレGPUサーバーの位置づけを解説します。
※本記事で掲載している料金は2026年6月時点で各社公式ページまたは公開価格情報サイトに記載の数値を引用しています。為替・リージョン・契約形態によって変動するため、最新の料金は各社公式ページでご確認ください。
【目次】
1. GPUクラウドとは?基本構成と特徴
GPUクラウドとは、データセンターに設置されたNVIDIA® H200 Tensorコア GPUやNVIDIA RTX PRO™ 6000 Blackwell搭載サーバーなどを、ネットワーク経由でアクセスし利用できるサービスです。物理サーバーを購入・設置せずに済み、サービスによっては短期間で利用を開始できます。また、時間単位・月単位での課金を行うサービスが多く、初期投資コストを抑えられる点も大きなメリットです。
ユーザーは手元のPCからクラウド上のGPUへ接続し、LLM学習・マルチモーダルAI・シミュレーションなど、処理に応じた台数を必要なときだけ利用できます。
近年は生成AI・LLMの学習・推論、シミュレーション、3DCG処理などでGPU需要が広がり、大規模な設備投資の前にPoCや中規模の検証をクラウドで進める使い方が定着しつつあります。オンプレミスではなくGPUクラウドを採用した際の主なメリットは、次の3点です。
- 初期投資の抑制
サーバー本体・電源・冷却設備を自社で用意する必要がなく、多くのサービスでは月額または時間単価のみで利用を開始できます。 - 短期間での利用開始
サービスによっては比較的短期間で利用を開始でき、物理サーバーの調達(数週間〜数ヶ月)と比べ、検証や立ち上げ期間を短縮しやすくなります。 - 最新世代GPUの利用
NVIDIA HGX H200 /B200、NVIDIA RTX PRO6000など、最新世代のアクセラレータに対応しているケースが多くあります。
オンプレミス型との導入形態の比較については、以下の記事で整理しています。
▶︎ GPUサーバー導入における、オンプレミスとクラウドの比較
GPUサーバーを利用する場合、オンプレミス/クラウドどちらを選べばよいのでしょうか?選定時の判断軸はさまざまありますが、今回は次の2つに基づき、代表的なサービスの例を挙げて紹介します。
- 軸①:データの置き場所 — 国内か、海外か、自社(オンプレミス)か
- 軸②:コスト — 時間課金で借りるか、月額課金で借りるか、購入して持つか
| 置き場所 | 代表的な選択肢 | データ面の特徴 |
|---|---|---|
| 海外 | 海外大手ハイパースケーラー(AWS、Azure、Google Cloud など) | 東京・大阪など国内リージョンが利用可能であればデータの国内保管に対応できる。事業者の所在国や契約条件の確認が必要となる場合がある。 |
| 国内 | NTTPCコミュニケーションズなど | 国内データセンターに配置されるため、データを国内保管できる。国内保管や国内法制度への準拠を求める要件に対応しやすい。 |
| 自社(オンプレミス) | 自社/自社管理のデータセンター | サーバーとデータを自社資産管理下に置き、ネットワーク経路やアクセス権限を自社要件に合わせて設計しやすい。クラウド事業者の基盤・料金体系への依存も抑えやすい。 |
この軸で検討対象になるのが、「データ主権」の考え方です。
- データ主権:医療データ・個人情報・設計データなど、管理要件の厳しいデータを扱う場面で重視されます。海外クラウドでも日本国内のリージョンを利用できますが、データ保管先に加えて事業者や契約面も含めた国内管理を求める場合は、国内クラウドやオンプレミスが選択肢となります。
2. 軸①:データの置き場所(国内 / 海外 / 自社)
1つ目の軸は、データと物理的なインフラをどこに置くかです。大きく、海外データセンター・国内データセンター・自社(オンプレミス)の3つに分かれます。
3. 軸②:コスト(時間課金 / 月額ベアメタル / 購入)
2つ目の軸は、コストです。GPUリソースの利用形態によって大きく異なる場合もあります。以下に主な特徴を整理しました。時間課金・月額ベアメタルはどちらも「借りる(クラウド)」、購入は「買って持つ(オンプレミス)」という分類になります。
| 利用形態 | 概要 | 適した用途 | 総額の特徴 |
|---|---|---|---|
| 時間課金インスタンス (借りる) |
インスタンス単位(コンテナ・VM)で借りる | PoC・短期検証・一時的にピークを迎える(季節変動など) | 短期は割安。稼働時間によっては月額課金以上になる場合もある。 |
| 月額ベアメタル (借りる) |
専有の物理サーバーを月額で借りる | 24時間×数か月稼働など、長期間にわたるプロジェクトでの運用 | 月額固定で総額を見通しやすい |
| 購入(オンプレミス) (持つ) |
物理サーバーを自社資産として保有 | 1年以上の長期間、大規模プロジェクト、外部クラウドに出せないデータの取扱い | 初期投資は要るが、長期で単価が下がる |
代表プランの料金で見る課金単位の違い
軸②の違いは、各社の代表プランを並べると明確になります。
以下にそれぞれのプランを整理しました。
| タイプ | 代表プラン例 | GPU構成 | 公開表記の料金 | 課金単位 | 最低利用期間 | 国内DC |
|---|---|---|---|---|---|---|
| 月額ベアメタル(国内):GPUクラウドforフィジカルAITM | GPUクラウドforフィジカルAITM | NVIDIA RTX PRO 6000×8 | 月額1,600,000円/初期150,000円(税別) | 月 | 最短3か月〜 | ○ |
| 時間課金インスタンス(海外大手3社) | NVIDIA HGX H200×8搭載インスタンス(オンデマンド) | NVIDIA HGX H200 ×8 | 米国リージョン例でおおむね $60台〜$110/hour 前後(事業者・SKU・リージョンで変動) | 時間 | 分単位(Capacity Blocks等は1日〜) | 国内リージョンを選択できる場合あり(東京・大阪など、事業者・SKUにより異なる) |
※表示通貨・GPU構成・参照リージョンが異なるため、換算は行わず公式表記のまま記載しています。海外大手3社の料金は米国リージョンの代表価格(オンデマンド)で、選ぶリージョンや契約形態(Capacity Blocks・Reserved等)によって費用は変動します。
※出典:GPUクラウドサービスページ/海外大手3社の料金は各社公式価格ページまたは公開価格情報サイト(オンデマンド・H200×8 SKU)を参照。
時間課金での利用は、稼働時間によっては月額課金以上のコストになる場合もあることに注意が必要です。たとえばH200×8インスタンスを概算例として米国オンデマンド単価$85/hour前後。24時間×30日稼働させると、月額$61,200(為替160円/USD換算で約980万円)、12か月分で約$735,000(同換算で約1.18億円)に相当します(※単価は事業者・SKU・リージョン・契約形態で変動。実際の見積もりは各社公式の価格ページで要確認)。
総額を見通しやすくしたい場合は、こうした時間課金の総額を月額ベアメタル(専有・固定月額)や購入(オンプレ)の費用と並べて検討するのが判断材料になるでしょう。
オンプレミス/クラウドの累積コスト比較結果は、以下の記事で具体的な数値で整理しています。
▶︎ クラウド vs オンプレミス GPUサーバーの利用コストを徹底比較!
また、「データ転送料」も確認しておく必要があります。クラウドから外部へデータを出すたびに発生する従量課金で、海外大手クラウドを中心に多くのクラウドサービスで採用されています(月額固定型の一部国内クラウドではデータ転送量の追加課金が発生しない例もあります)。
推論APIのレスポンス、学習データの取り出し、ログ転送など、運用が定着するほど積み上がる一方、クラウド利用において最も予算の見通しが立ちにくい隠れコストです。オンプレミスかつ閉じたネットワーク内で完結する処理なら、この転送料は発生しません。
4. 代表的なGPUインフラの立ち位置
ここまでの2軸(置き場所 × コスト構造)で、代表的な選択肢を位置づけます。
4-1. 2軸で見た各サービスの位置づけ
| サービス | 軸①:データの置き場所 | 軸②:コスト構造 |
|---|---|---|
| 海外大手ハイパースケーラー3社 | 海外中心(国内リージョンを選択できる場合あり) | 時間課金インスタンスが中心。利用時間によっては月額課金よりも高くなる。 |
| NTTPC GPUクラウドサービス for フィジカルAITM |
国内 | 月額固定制で専用(ベアメタル)サーバーを利用できる |
| その他の国内クラウド | 国内 | 時間/月額でリソースを利用できることが多い。 |
| オンプレGPUサーバー | 自社(閉域) | 初期投資と保守・運用に投資が必要だが、自由にリソースを利用できることが多い。 |
4-2. 提供GPUモデルの世代
冒頭で触れたとおり、主要な事業者ではH200やBlackwell系GPUの提供が広がっており、GPU世代だけでは差がつきにくくなっています。各社の対応世代を、A100以降に絞って整理します(新しい順:Blackwell系→H200→H100→A100、推論・グラフィックス用途向けとしてRTX PRO 6000およびNVIDIA L40S GPU。
| 事業者 | Blackwell系(B200/GB200など) | RTX PRO 6000 | H200 | H100 | A100 | L40S |
|---|---|---|---|---|---|---|
| NTTPC(国内) | 〇(B200) | 〇 | 〇 | ― | ― | ― |
| 海外大手ハイパースケーラー3社 | 〇(予約枠/Capacity Blocks経由) | 〇 | 〇 | 〇 | 〇 | 〇(一部事業者で提供) |
※海外大手3社のうち、Blackwell系(B200/GB200など)は予約枠やCapacity Blocks経由で提供されるケースがあり、提供SKUは事業者によって異なります。
※RTX PRO 6000およびL40Sの提供有無も事業者・SKUにより異なります。各事業者の最新の提供状況は公式ページでご確認ください。
GPUモデルごとの性能・選定基準は、以下の記事でも整理しています。
▶︎ データセンターGPU性能比較:指標別に見る製品の選定ポイント
4-3. ワークロード別の選び方
データの置き場所×コストで考えると、ワークロードごとに適したケースが見えてきます。
ここでは代表的なケースをまとめています。
- 短期のPoC・検証・季節的なピーク → 時間課金インスタンス
- 24時間×長期の学習・本番推論で総額を読みたい → 月額課金
- データを国内に置きたい・国内法準拠が要件 → 国内クラウド(または海外クラウドの国内リージョン)
- 機密データを社内で完結させたい・超長期で単価を抑えたい・データ転送料を極小化したい → オンプレミス(購入)
多くのワークロードは、1つの選択肢で対応する必要はなく、たとえば「定常的な学習はオンプレ、変動的な検証はクラウド」のように複数を組み合わせる(ハイブリッド)ことで、コスト・運用負荷・データ管理のバランスを取ることもできます。「国内クラウドで始め、必要に応じてオンプレを追加する」という段階的な進め方も可能でしょう。
5. NTTPCの提供内容(GPUクラウド / オンプレGPUサーバー)
NTTPCでは、国内データセンターで運用するGPUクラウドと、お客さま資産として提供するオンプレGPUサーバーの両方を扱っています。まずはクラウドではじめ、必要に応じてオンプレへ拡張する——といった段階的な拡張も一貫して支援します。
5-1. GPUクラウド for フィジカルAI™
国内では初めて※、 NVIDIA RTX™ PRO 6000 Blackwell Server Editionを採用するとともに、NVIDIA Omniverse™ライブラリやオープンなロボティクス シミュレーション フレームワークであるNVIDIA Isaac Simに対応し、デジタルツイン構築やロボットシミュレーションなどの開発環境として利用できる専有型ベアメタルGPUクラウドです。前述の2軸でいえば、軸①=国内、軸②=月額ベアメタル に位置します。
※国内主要GPUクラウドサービス事業者の公開情報に基づく当社調査(2026年7月時点)
ユーザーはインターネットまたはVPN経由で国内データセンター内のGPUサーバーへアクセスし、フィジカルAI開発・ロボティクスシミュレーション環境として利用できます。
GPUサーバーは専有利用のため、他利用者とのリソース競合を気にせず利用可能です。
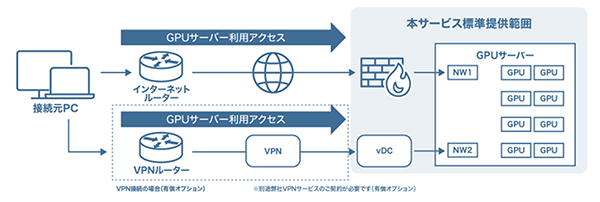
GPUクラウド for フィジカルAI™の構成概念図。
接続方法はインターネットまたはVPN(有償契約)から選択可能
主な特徴は次の通りです。
- フィジカルAI・ロボティクスシミュレーション向け
NVIDIA RTX PRO 6000 Blackwell Server Editionを8基搭載。RTコアを活用したリアルタイムレンダリングや、NVIDIA Omniverse™、NVIDIA Isaac Simを利用したシミュレーション環境に適しています。 - 国内データセンター運用(軸①)
国内データセンターで提供されるため、データ主権や国内運用を重視する案件でも利用しやすい構成です。 - 月額ベアメタルで総額を見通しやすい(軸②)
専有サーバーを月額固定で利用できるため、長期間の開発・検証プロジェクトでもコストを見積もりやすくなります。基本料金は月額160万円(税別)で、最低利用期間は3か月です。 - GPUエンジニアによるセットアップ支援
NTTPCのGPUエンジニアがセットアップやチューニングを実施し、利用開始までの負荷を軽減します。
料金やサービス詳細は、以下の公式ページからご確認いただけます。
▶︎ GPUクラウド|GPUならNTTPC|NVIDIAエリートパートナー
5-2. オンプレGPUサーバー
データを社外に出さない構成を取りたい、超長期・大規模プロジェクトのため自社資産化したい、といった要件には、オンプレGPUサーバーの構築・提供で対応します。前述の2軸でいえば、軸①=自社(閉域)、軸②=購入に位置します。大規模推論向けNVIDIA HGX™ B200搭載サーバーや、シミュレーション・レンダリング用NVIDIA RTX PRO 6000 GPU搭載サーバー、小型AI推論ワークステーションのNVIDIA DGX™ Sparkなど、多様な選択肢から用途に応じて提供します。
NTTPCのオンプレGPUサーバーの主な特徴は次の通りです。
- NVIDIAエリートパートナー(Best NPN2年連続受賞)
NVIDIA社からの認定パートナーであり、国内最高のアワード『Best NPN of the Year』を2025年、2026年に連続受賞。卓越した技術力と幅広い領域での実績が評価されています。 - サーバースペック選定から支援
ワークロードに応じたGPU・CPU・メモリ・ネットワーク・冷却・電源の組み合わせを総合的に設計・提案します。 - 「フルスタックエンジニアリング」による高い設計品質
GPUサーバーはもちろん、インターコネクト/ストレージ/管理ミドル・ソフトウェア/AIアプリケーションに至るまで、AI基盤を構成する技術全般に精通したフルスタックエンジニアが、システム全体の設計/構成および調達仕様とお客さまの要求事項を勘案し、適切な設計を行います。 - サーバーを運用するインフラ環境もトータルで設計・提供
自社独自のデータセンター、ネットワークサービスを提供し、電源管理、冷却方式(空冷 or 水冷)、外部ネットワーク接続、セキュリティ監視など、インフラ管理のためのナレッジも豊富に有しています。
オンプレGPUサーバーのベンダー別構成例や、具体的な見積もりについては、以下のページからご確認いただけます。
▶︎ GPUサーバー見積もりシミュレーター
6. まとめ
本記事では、GPUクラウドを中心に、オンプレミスも含めたGPUインフラの選択肢を、主に2つの軸で比較・整理しました。
- データの置き場所(国内 / 海外 / 自社) — データ主権・国内法準拠
- コスト— 利用形態(時間課金 / 月額ベアメタル / 購入)、総額
GPUクラウドを比較・検討する際に重要なのは、この2つの軸を切り分けて考えることです。短期・変動的な利用には時間課金、定常的・長期的な利用には月額ベアメタル、外部環境にデータを出さない長期運用にはオンプレミスでの購入、というように使い分けるのが現実的です。用途や要件に応じて、これらを組み合わせて設計することが重要でしょう。
NTTPCコミュニケーションズは、NVIDIAエリートパートナーとして、「国内×月額ベアメタル」のGPUクラウドや、「購入」のオンプレGPUサーバーの両方を扱っています。国内クラウドで始めて段階的にオンプレへ拡張する形も含め、お客様のご要件に応じた基盤設計をご相談いただけます。GPUインフラの選定やハイブリッド構成について、お気軽にお問い合わせください。
▶︎ お問い合わせはこちら
※NVIDIA、NVIDIA H100 Tensorコア GPU 、 NVIDIA H200 Tensorコア GPU、NVIDIA RTX PRO 6000、NVIDIA HGX H200、NVIDIA HGX B300,NVIDIA B200 GPU、NVIDIA L40S GPU、NVIDIA GB200 Blackwell、NVIDIA Omniverse、NVIDIA Isaac Sim、NVIDIA DGX Sparkは米国およびその他の国におけるNVIDIA Corporationの商標または登録商標です。